顯示具有 OpenCL 標籤的文章。 顯示所有文章

2023年11月5日 星期日

OpenCL 1.2 之後(個人觀點中)重要的 feature 與 extension

最近因工作緣故, 而看到了使用 subgroup 特性的實作, 在第一時間個人難以解讀程式碼的目的與原意,  後來看了原始實作與擴充功能的說明文件才得知 subgroup 的功能特性為何. 主要因為個人對於 OpenCL 2.x 印象僅停留在 Shared Virtual Memory. 然而事實上 OpenCL 2.0 到 OpenCL 3.0 這段期間依然有數個實用的功能特性與擴充 對於 OpenCL 3.0 而言, 這些 2.0 以後加入的新 features 與 extensions 都屬於 extension. 因此可以到 The OpenCL™ Extension Specification 頁面一一查看. 以下列出個人覺得實用的 extensions:

Creating a 2D Image From A Buffer

許多時候人們很希望能透過 vload / vstore 來存取 buffer, 又希望能夠使用 GPU 的 texturing unit. 在 OpenCL 1.x 的時代, 通常是透過 ION buffer 來重複 mapping 到 Buffer 與 Image, 並且傳入對應的 kernel 中使用. 基本上這需要 GPU vendor 確認 cache coherency 的問題, 甚至提供對應的 driver 支援. 在 OpenCL 2.0 中將類似功能成為 core feature, 也就是 OpenCL 2.0 中是必要的存在. 透過 cl_khr_image2d_from_buffer 這個 extension, 可以先配置 Buffer 後再以此 Buffer 來建立 Image. 一開始提到相同目的.

Subgroups

儘管 OpenCL 中提供了 Global 與 Local work size 來對整體工作做切割, 而 Local work size 另一個重要的意義是對應的 workgroup size 是能作同步的最小單位. 在 OpenCL 2.1 中新增了這個 core feature. 在 Workgroup 中能夠再切分一個 1D 的 subgroup, 除了 subgroup 層及的 barrier 做同步外, 也提供了 3 個種類的 kernel function: reduce_op, scan_exclusive_op 與 scan_inclusive_op. 這些 operation 對於 reduction 與 integral 這兩類原本 OpenCL 不適合應付的計算提供了有效的介面, 讓 device 能夠使用硬體支援來處理這類的計算.

Mipmaps

在 OpenGL 中支援以硬體產生 Mipmaps 來做 texturing. 可以避免 aliasing. 這裡應該是同等的結構. 但除了做原本 antialiasing 用途外, 不知是否有機會利用這個 pyramid 結構來做 CV 應用.

Integer Dot Product

OpenCL 中原本只支援 float / double 型別的內積 (dot product), 然而現今 NN 應用中 8-bit integer dot product 的需求相當大. 這個 extension 有效的提供了對於 8-bit dot product 硬體加速的介面. 理論上透過 multiplication 搭配 subgroup 就可以得到相同結果, 但若支援此 extension 且俱備硬體加速, 可以得到更高的 computation throughput.


當然 OpenCL 2.x 系列還是有其他像是 SVM, device-side enqueue 與 Pipe 的功能, 有時間再來寫程式並撰文說明這些功能的實際的應用.


2023年10月14日 星期六

OpenCL 在 2023 相關的研讀資料 / 工具

儘管近年已經沒有密集使用 OpenCL

但最近同仁因工作而起的 OpenCL 相關實務討論還是令我相當感興趣與熱衷

雖然 OpenCL 在現今已不是各家密集發展的重點技術標準

然而在有實際應用場景需求, 但沒有更好的新標準, 儘管各家計算硬體開發商缺乏合作默契的情況之下(特別是 Mobile 平台), 繼續良好支援 OpenCL 似乎是實務上的一個共識了

這篇主要的目的是統整一下在 2023 的今日要著手 OpenCL 有哪些資料可以研讀

書籍

由於 OpenCL 3.0 標準是以 OpenCL 1.2 為基底, 因此過往的 OpenCL 圖書內容都還是相當實用. 至於談到 OpenCL 2.0 標準後新增的部份 (個人覺得現今 OpenCL runtime 逐漸完備下 device-side enqueue, subgroup 以及 pipe 都可以把玩一番), 而目前僅有一本參考書目可以研讀 - "Heterogeneous Computing with OpenCL 2.0", 這本書被標為 3rd edition 的原因是前面有著兩版談論 1.1 與 1.2 的兩個版本

標準與相關資訊

OpenCL 的制定組織統整了 OpenCL 相關的資源連結 - OpenCL Resource Guide

若要查找標準相關的資訊, 另外是相關的程式資源, 這裡算是參考資料翻找的入口

各 GPU vendor 提供的 OpenCL Programming Guide

由於各家還是有自己的 OpenCL runtime 與 compiler 實作, 因此在使用與實作 OpenCL 程式還是有各家平台在 Host 與 Device 中需要注意的一些細節. 這裡整理了各家目前提供的文件.

Intel

OpenCL Developer Guide for Intel® Processor Graphics

AMD 

ROCm OpenCL Programming Guide (這是 archive.org 在去年底的備份, 其實不清楚為何 AMD 再最新的文件中將 OpenCL 的部份移除)

Nvidia

NVIDIA OpenCL Best Practices Guide Version 1.0

NVIDIA OpenCL SDK Code Samples

Qualcomm

Qualcomm Snapdragon  Mobile Platform OpenCL General Programming and
Optimization
(原名 Adreno OpenCL Programming Guide)

ARM

Mali GPU Bifrost Valhall OpenCL Developer Guide

Mali Midgard OpenCL Developer Guide

Imagination

A quick guide to writing OpenCL kernels for PowerVR Rogue GPUs (Imagination 事實上是有 OpenCL performance optimization 相關文件, 只是比較可惜的是僅會對客戶提供)

工具

與 Optimization Guide 類似, 由於 GPU hardware counter 並沒有一致性的標準與介面, 所以這部份比較可惜的是必須仰賴各家的 Offline Compiler 與 Profiler

Intel

Intel® Graphics Performance Analyzers

Ahead-of-Time Compilation for GPU

AMD

Radeon GPU Profiler

Radeon GPU Analyzer

Nvidia

NVIDIA Visual Profiler

NVIDIA CUDA Compiler (NVCC)

Qualcomm

Snapdragon Profiler

Adreno GPU SDK

ARM

Mali Graphics Analyzer

Mali Offline Compiler

Imagination

PVRTune

PVRSHADEREDITOR


2018年8月14日 星期二

OpenCL Image 的妙用


曾提過許多的 OpenCL 的 wrapper 都不重視 Image 這個型別, 僅僅提供 Buffer 的物件, 這樣的作法除了錯誤地認為都僅只是 memory buffer 外, 忽略了 GPU 架構設計上的本質是相當可惜的.

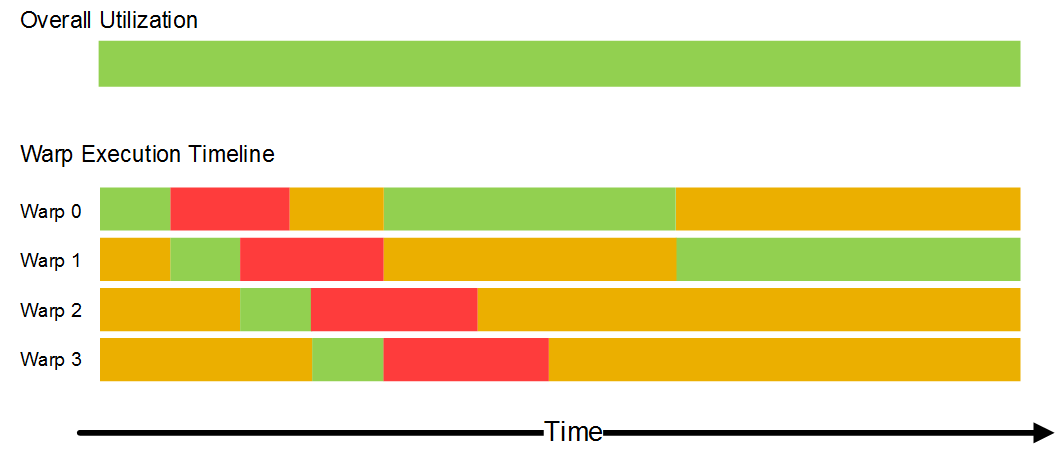
在 CPU 上 memory access latency 的降低仰賴的是 cache, 對於 GPU 而言靠的是 wavefront(warp)/threads 的切換來吸收, 這裡以 Imagination 曾經介紹過其 PowerVR Rouge 的運作機制 來做說明 (其他的 GPU有作法不同但本質相同或類似的方式):

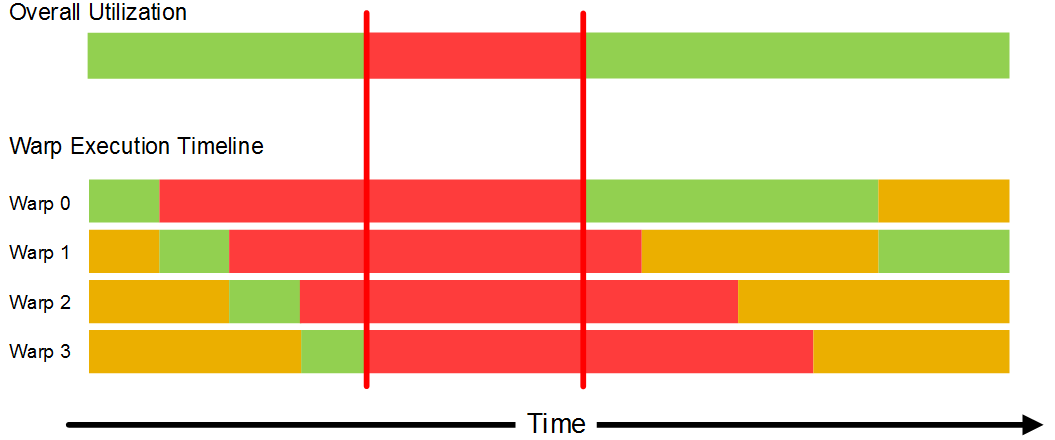
Rogue GPU 一個 Warp 基本上是 32-theads, 內部有著 16組 Warp slot 作排程切換, 由於每個 Warp 中的 32-threads 是以 lock-step 進行, 因此一旦有 thread 的執行狀態沒有被滿足整組 Warp 即被切為 idle state(紅色). 而如同上圖, GPU 是在期間一一切換尋找 ready state (黃色) 的 warp. 而如同影響 CPU 最大的一般, 其中最常出現的即為 memory latency. 一旦 memory latency 過高, 或是 bandwidth 不足就會發生下圖類似 CPU 的 memory stall 的情況:

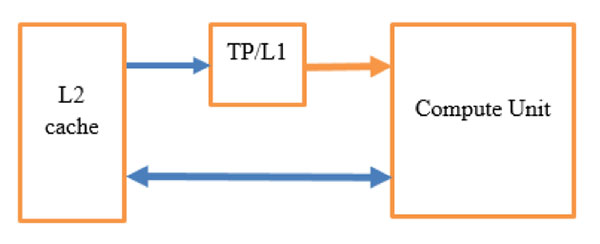
那麼這與 Image的使用有何關連? - 因為多數的 GPU texture unit 有著自己的 memory pipeline 與 cache.  這表示以 texture unit 搭配既有的 memory pipeline 合併使用, 因此能夠相較於僅使用 Buffer 的情況下, 提供 PE/ALU 更高的 memory throughput.

像是 Qualcomm 提及(TP 即為為 Texture Pipe):
Texture pipe
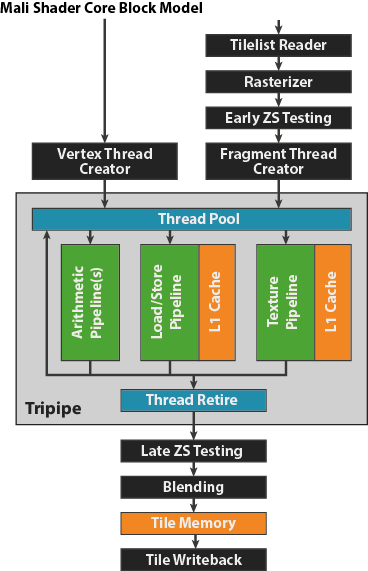
而像是 ARM Mali GPU 的說明也很清楚:
「Mali Texture Cache」的圖片搜尋結果

其他 Intel, NV, AMD GPU 都有著類似的方式.

在 cltk 中提供了一個簡單的範例 - gemm, 其中 gemm.cl 有兩個 kernel, 兩者主要差異在於一個完全使用 Buffer 而另一個有使用 Image. 相信很多人有疑問, 為何 GEMM 能夠以 Image 方式實作. 這仰賴兩件事
  1. 以整數座標, 並且不使用 sampler 的方式來透過 read_imagef 來讀取 Image
  2. data layout 的擺放方式為 CL_RGBA
滿足上述的方式, 就可以依序讀取 float4 (或是指定的資料型別)的向量.

使用 image 的 kernel:
__kernel void sgemm_buf_img(
   __global const float *A,
   const int lda,
   __global float *C,
   const int ldc,
   const int m,
   const int n,
   const int k,
   __read_only image2d_t Bi
){
    int gx = get_global_id(0) << 2;
    int gy = get_global_id(1) << 3;

    if ((gx < n) && (gy < m)){
        float4 a[8];
        float4 b[4];
        float4 c[8];

        for (int i = 0; i < 8; i++){
            c[i] = 0.0f;
        }
        A += gy * lda;

        for (int pos = 0; pos < k; pos += 4){
            for (int i = 0; i < 4; i++){
                b[i] = read_imagef(Bi, (int2)(gx >> 2, pos + i));
            }

            for (int i = 0; i < 8; i++){
                a[i] = vload4(0, A + mul24(i, lda) + pos);
                c[i] += a[i].x * b[0] + a[i].y * b[1] + a[i].z * b[2] + a[i].w * b[3];
            }

        }

        for (int i = 0; i < 8; i++){
            int C_offs = mul24((gy + i), ldc) + gx;
            vstore4(c[i], 0, C + C_offs);
        }
    }
}
不使用 Image 的 Kernel:
__kernel void sgemm_buf_only(
   __global const float *A,
   const int lda,
   __global float *C,
   const int ldc,
   const int m,
   const int n,
   const int k,
   __global const float *B
){

    int gx = get_global_id(0) << 2;
    int gy = get_global_id(1) << 3;

    if ((gx < n) && (gy < m)){
        float4 a[8];
        float4 b[4];
        float4 c[8];

        for (int i = 0; i < 8; i++){
            c[i] = 0.0f;
        }
        A += gy * lda;

        for (int pos = 0; pos < k; pos += 4){
            for (int i = 0; i < 4; i++){
                b[i] = vload4(0, B + (pos + i)*ldc + gx);
            }

            for (int i = 0; i < 8; i++){
                a[i] = vload4(0, A + mul24(i, lda) + pos);
                c[i] += a[i].x * b[0] + a[i].y * b[1] + a[i].z * b[2] + a[i].w * b[3];
            }

        }

        for (int i = 0; i < 8; i++){
            int C_offs = mul24((gy + i), ldc) + gx;
            vstore4(c[i], 0, C + C_offs);
        }
    }
}

以下為在個人的 Geforce 860M 上的執行結果
$ LD_LIBRARY_PATH=. ./gemm
build log:
cltk_image_alloc w[1024] h[1024] p[1024] us[16]
B pitch 1024 usize 16
pitch 16384
main test overhead gemm takes 103910 us
check result 1...
main test overhead gemm_buf takes 130500 us
check result 2...
兩者間有著近 30% 的效能差距, 若搭配 local memory 的使用或是在手機平台, 效能差距比例應會更明顯.

這個 GEMM 的範例主要參考自 Qualcomm 的 Optimization 文章, 並撰寫對比的 kernel

2018年7月23日 星期一

在 Vulkan 中使用 OpenCL Kernel


OpenCL kernel 在 Vulkan 上的使用

OpenCL 自 2008 年底釋出 1.0 至今過了十個年頭,
在 GPGPU 面向上也累積了相當的開發者社群,
儘管 Desktop 上熱烈程度不如 Nvidia CUDA,
而 Mobile 上因 Google 的錯誤決定去強推 RenderScript,
造成手機商在配置與否的態度不一
這樣的情況造成 OpenCL 的使用程度上既不熱烈,
然而許多情況下又是唯一方案


在 Vulkan 的推出後,
由於其基於 SPIR-V 標準的特性, 讓許多應用能夠依附於此之上
其中之一即為 OpenCL kernel 的使用
透過預先以 compiler 將 OpenCL kernel 轉為 SPIR-V binary
再搭配 Vulkan 載入與使用 Compute Shader 的方式, 得以間接的使用 OpenCL 語法

所需的第一個工具為:
https://github.com/google/clspv
clspv 為將 OpenCL kernel 編譯出 SPIR-V 的 Compiler

再來即為 Vulkan 對應 OpenCL Host Code 的使用流程
網路上可以找到下列三篇提及 OpenCL Host => Vulkan 流程轉換的 Blog 文
OpenCL -> Vulkan: A Porting Guide Part I
OpenCL -> Vulkan: A Porting Guide Part II
OpenCL -> Vulkan: A Porting Guide Part III
以及該系列文作者於 Khronos Munich 2017 的簡報: OpenCL to Vulkan: A Porting Guide

若跳過對 OpenCL 與 Vulkan 的對應, 想直接切入 Vulkan Compute Shader 流程
該作者的 A simple Vulkan Compute example 一文以及 GitHub gist 幫助就相當大

個人透過上述幾篇, 實作了上述 Compute Example 等義的 CL kernel
並整合開源放上 https://github.com/champyen/vkcl
以 Intel HD Graphics 500 搭配 Mesa Vulkan 實作, 能正確執行

儘管因此能夠撰寫 OpenCL kernel 來在 Vulkan 環境中使用, 然而並不代表沒有任何限制
相關限制都在 clspv 的 OpenCLCOnVulkan 文件中

Kernel
  • argument 非 buffer/image 型別, 會透過整合到一個 buffer 方式傳入 
  • WorkGroupSize 無法透過 host 指定, 似乎只能以 __attribute__ ((reqd_work_group_size(x, y, z))) 方式指定
  • 無法呼叫其他 Kernel
  • 不能使用 local 作為 argument
  • 不能使用 half 作為 argument
(事實上, 相關 argument 自 Host 傳遞到 Kernel 的機制也並不是很方便)

Types
  • boolean 無法作為 global, constant, 而 sizeof 為未定義行為
  • 8-bit, 64-bit, event_t 型別無法使用
  • 沒有長度為 8, 16 的向量 (也就是儘支援向量長度 2, 3, 4)
  • pointer 的限制很多
Built-In Functions
這部分相當的多, 都是無法使用, 簡短提示如下:
  • atomic: atomic_xchg()
  • common: step(), smooth_step()
  • conversion: 俱備 rounding, saturation 都不可使用
  • math, integer, rational: 這部分特定的 function 無法使用, 請參考說明
  • async, shuffle, printf, vload/vstore: 請直接當不存在 ...

Vulkan GLSL Compute Shader

OpenCL kernel 在 Vulkan 1.0 上運作需要兩個 extension:

  • SPV_KHR_variable_pointers
  • SPV_KHR_storage_buffer_storage_class
此兩個 extension 於 Vulkan 1.1 中成為核心特性 (因此日後可以基於上述限制來使用 OpenCL)
若考量 Vulkan 1.0 裝置的相容性, 那麼採用 GLSL Compute Shader 方式撰寫是不錯的選擇

此外 Vulkan GLSL compute shader 的相關範例也並不多, 以下是看到覺得不錯的
https://github.com/Erkaman/vulkan_minimal_compute
https://github.com/alexhultman/libvc
https://arm-software.github.io/vulkan-sdk/basic_compute.html

撰寫 Vulkan GLSL compute shader 也需要 compiler 產生 SPIR-V
這時 LunarG 的 Vulkan Toolchain 能夠直接下載使用
https://vulkan.lunarg.com/sdk/home

update: 值得一提的是與 OpenGL GLSL compute shader 的不同, OpenGL GLSL compute shader 制定時, 能使用的 builtins 受限於既有 GLSL 部分, Vulkan 制定的時候對其做了擴充, 能使用的函式較接近原有的 OpenCL:
https://www.khronos.org/registry/spir-v/specs/unified1/GLSL.std.450.mobile.html

2017年4月2日 星期日

"ARM Compute Library for computer vision and machine learning" III - 總結

在實作上核心的實作是在各功能的 Kernel 類別實作中
因此若想瞭解可以去研讀各個繼承 IKernel 的 CL/NEON 實作
由系列文 II 多少可以了解 ARM Compute Library 是如何的工具
在官方的介紹也說明了這是 - a collection of low-level software functions
這樣的好處是設計簡單且易於使用, 若所需要功能不複雜, 其所提供的工具也相當堪用
但是若一個目的是需要使用多個 Kernel 的串連來達成
如此的應用就需要更進階的方式來作優化
以 OpenVX 來說即為其 Graph pipeline
基本上需要透過一個更為高階的抽象層
為問題帶入各個 stage 的分割與相關排程的分析
對於 ARM Compute Library 而言每個 function 需要 I/O image buffer
能接近這樣的方式在於兩個 stage 間以 Window + Thread 的 Tiling 方式
如此也僅是有限度地利用 data locality 的特性增加 cache 的有效性
況且對於 Load/Store 指令可是一個都沒能因此節省
(這需要能作 operation fusion 的 compiler)
這即是 ARM Compute Library 在效能與進階功能上的局限


然而若需要進一步解決上述的局限
會需要能針對 temporal/spatial scheduling 作 dynamic code generation 的 compiler以及 runtime
實作複雜度亦會大幅增加 (即 OpenVX/Halide 或類似的實作)

2017年3月28日 星期二

"ARM Compute Library for computer vision and machine learning" II - Framework 篇

ARM Compute Library 的使用上的 class 主要有二類分別是針對 data 以及 task/workload
data 類別為: Image/Tensor, TensorInfo
task/workload 類別為: Kernel, Window 與 Function
下列的內容主要為 ARM Compute Library: Documentation 所描述

並且搭配 source code 的內容做特定用途的說明
(取代文件內 MyKernel, MyFunction 的方式)

由於 ARM Computer Library 是做 Computer Vision 與 Machine Learning 應用的
因此主要處理的資料型別為 Image 及 Tensor
在 Compute Library 中基本上只是名稱不同而已

Image, Tensor, TensorInfo

在 NEON 下直接使用 Image
Image     src, dst;
而在 CL 下則使用 CLImage
CLImage   src, tmp, dst;
Image 宣告後並沒有實際的 buffer 空間, 必須進一步最配置的動作,配置的方法有二, 兩者都需要傳遞 TensorInfo 資訊, TensorInfo 基本上為 Image/Tensor 各維度的大小以及資料格式
配置的第一種方式為直接透過 Allocator 的 init() 方式
src.allocator()->init(TensorInfo(640, 480, Format::U8));
而第二種方式為先呼叫 configure() 在呼叫 Allocator 的 allocate()
TensorInfo dst_tensor_info(src.info()->dimension(0) / scale_factor, src.info()->dimension(1) / scale_factor, Format::U8);
dst.allocator()->init(dst_tensor_info);
dst.allocator()->allocate();

Kernel, Window & Function

空間配置好之後, 就必須透過各種各樣的 Kernel 來套用對應的功能來操作 Image/Tensor
使用上的核心 class 為 Kernel, 各個 Kernel 實作了 IKernel 相關的介面

使用的第一個步驟為宣告想使用的 kernel object, 假設我們想作 image scale
//Create a kernel object:
NEScaleKernel scale_kernel;
在使用之前必須對 kernel 作 input, output 使用參數以及 padding mode 作設定
// Initialize the kernel with the input/output and options you want to use:
Tensor offsets;
const TensorShape shape(dst.info()->dimension(0), dst.info()->dimension(1));
TensorInfo tensor_info_offsets(shape, Format::S32);
tensor_info_offsets.auto_padding();
offsets.allocator()->init(tensor_info_offsets);
scale_kernel.configure( &src, nullptr, nullptr, &offset, &dst, InterpolationPolicy::NEAREST_NEIGHBOR, BorderMode::UNDEFINED);

offsets.allocator()->allocate();
// compute offset 
...
這裡使用了 NEAREST Filter, 並且使用 UNDEFINED padding 方式 (對於邊界有缺所需資料的點不做處理)

最後就是呼叫使用該功能,即是呼叫 IKernel 的 run() 介面
// Retrieve the execution window of the kernel:
const Window& max_window = scale_kernel.window();
// Run the whole kernel in the current thread:
scale_kernel.run( max_window ); // Run the kernel on the full window
這些即為 Compute Library 基本的使用方法.
對於 CL Kernel 則有稍微不同的 flow (需要特別傳入以操作 cl::CommandQueue)

或許會覺得上面例子的 max_window 很多餘, 但它是有進階應用的
Window 用途在於對 Kernel 指定要套用執行的範圍描述
在官方說明文件是以 Multi-Threading 的方式來說明 Window 的用途
const Window &max_window = scale_kernel->window();
const int num_iterations = max_window.num_iterations(split_dimension);
int num_threads    = std::min(num_iterations, _num_threads);
for(int t = 0; t < num_threads; ++t){
    Window win = max_window.split_window(split_dimension, t, num_threads);
    win.set_thread_id(t);
    win.set_num_threads(num_threads);
    if(t != num_threads - 1){
        _threads[t].start(kernel, win);    }else{
        scale_kernel->run(win);    }
}
當下列所有的條件都符合後, Window 可以用來分割 workload 為多個子 Window
  • max[n].start() <= sub[n].start() < max[n].end()
  • sub[n].start() < sub[n].end() <= max[n].end()
  • max[n].step() == sub[n].step()
  • (sub[n].start() - max[n].start()) % max[n].step() == 0
  • (sub[n].end() - sub[n].start()) % max[n].step() == 0

至於 Function 的使用則是為了簡化繁雜的 Kernel, Window 的使用流程, Function 實作內部會自行配置所需的暫存  buffer, 甚至能透過上述的方式自行做 Multi-Threading
// Create and initialize a Scale function object:
NEScale scale;scale.configure(&src, &dst, InterpolationPolicy::NEAREST_NEIGHBOR, BorderMode::UNDEFINED);
// Run the scale operation:
scale.run();
若使用的為以 CL 實作的 Kernel 最後還有個確保執行完成的額外同步動作
// Make sure all the OpenCL jobs are done executing:
CLScheduler::get().sync();

如此一來 Function 比起直接使用 Kernel 簡化不少

在下一篇會進入 NEON 與 CL 內部實作方式的說明

2017年3月26日 星期日

"ARM Compute Library for computer vision and machine learning" I - Overview 篇

日前 ARM 官方透過 github 並且以 MIT License 方式再次正式地釋出了 Compute Library 的原始碼(先前提供了 internal evaluation only 的 binary, 詳請請回顧當時的 release note), 這是個 low-level implementation, 而且是 pure function 的形式, Compute Library 提供了涵蓋下列的功能函式:
  • 基本的運算, 數學與布林運算函式 (Basic arithmetic, mathematical, and binary operator functions)
  • 色彩操作, 包含轉換, 頻道擷取與其他 (Color manipulation (conversion, channel extraction, and more))
  • 捲積濾波器 (Convolution filters (Sobel, Gaussian, and more))
  • Canny Edge, Harris corners, optical flow, and more
  • Pyramids (such as Laplacians)
  • HOG (Histogram of Oriented Gradients)
  • SVM (Support Vector Machines)
  • 半/全精準 通用矩陣乘法 (H/SGEMM (Half and Single precision General Matrix Multiply))
  • 捲積類神經網路建構功能區塊 (Convolutional Neural Networks building blocks (Activation, Convolution, Fully connected, Locally connected, Normalization, Pooling, Soft-max))
對於 Compute Library 來說, 它屬於個人介紹過的(請參考SIMD Introduction 簡報) SIMD Programming Model 中的 SIMD Optimized Library, 概念與與提供的效能上, 可以參考 ARM 官方釋出的介紹文,  本系列文會專注於 Compute Library 內部架構與更細節的如何使用, 所提供的能力以及, 以及探討使用這樣的 Library 依然存在什麼樣的限制.

首先 ARM Compute Library 其 github 位置為 https://github.com/ARM-software/ComputeLibrary , 而相關的原文文件在 source 與網站上各有一份

以目錄結構來說下列為主要較重要的目錄:
  • arm_compute/ - 放置所有 Compute Libraray 的 Headers
    • core/ - Core library 是由底層演算法的實作所組成
      • 基本共用資料型別 (Types, Window, Coordinates, Iterator, 等等)
      • 基本通用介面 (ITensor, IImage, 等等)
      • 物件 metadata 型別 (ImageInfo, TensorInfo, MultiImageInfo)
      • backend 目錄
    • runtime/ - Runtime library 是用來快速 prototyping 用途非常基本的 Core Library 的 wrapper (由於 CL/NEON 的 Programming Model, 這裡提供對應不同的 execution interface)
      • 基本通用物件介面的實作(Array, Image, Tensor, etc.)
    • 以上兩者, 內各自有 CL/CPP/NEON backedn 目錄, 提供對應 backend 定義的 kernel headers
  • documentation/ - Doxygen 所產生的文件
  • examples/ - 內有提供的 4 個範例程式
  • include/ - 基本上只放置 OpenCL 1.2 的 Headers
    • CL/
  • src/
    • core/ - 於 arm_compute/core/ 中定義的型別/介面的實作
    • runtime/  - 於 arm_compute/runtime/ 中定義的型別/介面的實作
    • 以上兩者, 內各自有 CL/CPP/NEON 目錄, 即為該 backend 實作相關原始碼

而值得一提的是在 Compute Library 中提供的功能中, 這些 Kernel 演算所使用的定義規範為 OpenVX 1.1 所制定的

以下為目前提供的 Kernel 列表, 若了解 image processing, DNN 該 function 名稱應解釋了其功用, 即不在此冗文解釋: (注明 NEON-only 表示目前尚未有 CL 實作)
AbsoluteDifferenceKernel
AccumulateKernel
ActivationLayerKernel
ArithmeticAdditionKernel
ArithmeticSubtractionKernel
BitwiseAndKernel
BitwiseNotKernel
BitwiseOrKernel
BitwiseXorKernel
Box3x3Kernel
CannyEdgeKernel
ChannelCombineKernel
ChannelExtractKernel
Col2ImKernel
ColorConvertKernel
ConvolutionKernel
ConvolutionLayerWeightsReshapeKernel
CumulativeDistributionKernel (NEON-only)
DepthConvertKernel
DerivativeKernel
DilateKernel
ErodeKernel
FastCornersKernel
FillArrayKernel (NEON-only)
FillBorderKernel
FillInnerBorderKernel (NEON-only)
Gaussian3x3Kernel
Gaussian5x5Kernel
GaussianPyramidKernel
GEMMInterleave4x4Kernel
GEMMLowpMatrixMultiplyKernel
GEMMMatrixAccumulateBiasesKernel
GEMMMatrixAdditionKernel
GEMMMatrixMultiplyKernel
GEMMTranspose1xWKernel
HarrisCornersKernel
HistogramKernel
HOGDescriptorKernel (NEON-only)
HOGDetectorKernel (NEON-only)
HOGNonMaximaSuppressionKernel (NEON-only)
Im2ColKernel
IntegralImageKernel
LKTrackerKernel
MagnitudePhaseKernel
MeanStdDevKernel
Median3x3Kernel
MinMaxLocationKernel
NonLinearFilterKernel
NonMaximaSuppression3x3Kernel
NormalizationLayerKernel
PixelWiseMultiplicationKernel
PoolingLayerKernel
RemapKernel
ScaleKernel
Scharr3x3Kernel
Sobel3x3Kernel
Sobel5x5Kernel
Sobel7x7Kernel
SoftmaxLayerKernel
TableLookupKernel
ThresholdKernel
TransposeKernel
WarpKernel (CL 細分為 WarpAffine, WarpPerspective 兩種)

下一篇將會介紹 Compute Library 中使用所需了解的基本型別, 介面, 執行方式以及範例

2017年3月19日 星期日

OpenCL Programming Tips for Qualcomm Adreno GPU 導讀

目前手機多半都有內建 OpenCL Runtime
(除了 Google 無謂地堅持 RenderScript, Do Evil 地阻礙標準的採用)
對於 OpenCL 有所了解的人, 多半清楚 OpenCL 是 function portability, 而無法做到 performance portability, 這其中的緣由主要還是在於各家的 GPU Architecture 的差異, 因此多半各家 GPU vendor 都會提供自家 OpenCL Optimization Guide, 以利開發者對自家平台優化應用性能

目前手機可能內建的 GPU 主要為三
  • ARM Mali
  • Imagination PowerVR
  • Qualcomm Adreno
由於個人 OpenCL 經驗多半與前兩者有關,  由於未曾接觸, 因此對於 Adreno 部分有很大的興趣, 因而選擇研讀與撰文. 這篇主要的內容主要來自下列公開的 Adreno OpenCL Programming Guide 文件. 有機會也會撰文介紹 ARM Mali 與 Imagination PowerVR 的 Programming Guide

Adreno OpenCL Programming Tips

Memory

其第一個章節即是 "Memory", 對於計算架構來說 Memory 幾乎是效能上的關鍵, 對於 GPU 亦不例外, 而在這份文件中 Memory 章節佔了一半的份量, 可見其重要性, 對於 Adreno GPU 而言, 其考量點有五:
  • Vectorization and coalescing 
對於 memory access 而言, Coalescing 是常用的方式, 儘管一些 compiler 會透過 auto-vectorization 嘗試去優化 workgroup 內更有效率的存取, 但是 programmer 自行作 vectorization 並控制 access pattern 對於後續的 finetune 是重要的. 一旦 vectorization 後, OpenCL 提供兩個介面做 vector loading, 一者為 vector-based pointer arithmetic, 另一為 vloadn 的方式, 這裡 Adreno 建議以 vloadn 並且不建議 n > 4. (這必定也只是一個 common rule, 程式的流程與記憶體的行為也會有差異)
  • Image vs. buffer memory objects
 OpenCL 的記憶體使用分為兩種 abstract object, 一者為 Buffer 另一為 Image Object, 對於 Image 所提供的優點如下:
主要是相較於 Buffer 多了 L1 cache (這是 Texture Unit 的特性所增加), 另外就是硬體加速的線性內插的計算, 以及最後是能夠透過硬體自動處理邊界的問題(以 Buffer 而言需要增加 GPU 所不擅長的 if/else 的 code)
  • Global memory (GM) vs. local memory (LM)
在 Global Memory(GM) 與 Local Memory(LM) 間應注意的事情有三, barrier 的使用, 再者為搬移資料需要考量的 cost, 最後是將資料存放在 LM 的條件
對於 Kernel 撰寫實作熟悉者, 應該對於 barrier 的使用會有相當的 overhead 不陌生, 但是對於一些有 data dependency stages 的實作這又是必要的, 減少 barrier 的使用幾乎是所有 GPU 平台一致要納入考量的點.
儘管 LM 有著較低的 latency 但對於 Adreno GPU 來說 GM 到 LM 的途徑中需要使用 GPU 內部的暫存器, 隨著需要搬移的資料數目耗費的暫存器可能會引起 register spilling 問題, 另外 Adreno GPU 對於 GM 有 L2 cache, 因此並不是直接將資料放置於 LM 就能獲得效益.
對於需要放置到 LM 的條件, 這裡建議 LM 存放介於兩個 stage 中間的資料, 或是會被使用至少三次的 input data.
  • Private memory
對於多數的 GPU 架構 private memory 對應到的地方是暫存器, 對於 Adreno 亦不例外, 由於 general register 數目有限, 若不良的 coding style 會造成 register spilling, 而一旦這樣的情況發生, Adreno 會嘗試自 LM 調度, 若 LM 不足則最後會調度到 GM, 這樣的流程若頻繁發生, 可以預期的是效能會大幅降低. 因此對於想要宣告為 array 的變數, 建議直接使用 LM. 其實除了這樣之外,  可以做 in-function 的 multi-stages 方式, 積極地將 kernel 透過多個 stage subroutine 來實作, 最後手段是透過精準的 variable life-scope 控制(也就是加入 {} 大括號, 主動提供 compiler 資訊) 來減少 register 的使用.
  • Constant memory
 Adreno 提供了相對特別的 constant memory (經驗上來說常看到架構會使用 LM 作為存放 constant 的地方), 然而大小為 3KB, 超過的部分系統會放在 GM 中, 對於透過 Kernel Argument 傳入的 constant buffer 需要透過屬性的設置來預期會被放置於 constant memory.(詳細請參考 1. 文件)

Zero memory copy

如同其他 OpenCL Runtime, 若需要同時 CPU/GPU 能夠存取, Buffer/Image 的配置要透過 CL_MEM_ALLOC_HOST_PTR 這個 flag 來取得能夠讓 CPU/GPU 無需 data copy 的空間, 在透過Map/Unmap 的方式來使用. 然而對於除了 CPU, GPU 外的硬體需要使用, 需適當地選擇 cl_ion_qcom_host_ptr 或 cl_qcom_android_native_buffer_host_ptr 這兩個 flag 來使用

Work group size and shape

儘管多數 OpenCL 教科書建議在 Kernel 執行時輸入將 local work size 參數傳入 NULL, 讓 Runtime 自動配置最適當的 WorkGroup size, 但是 Adreno 還是提醒這樣的作法其實並不總是最佳的(事實上所有的平台都不是), programmer 應該嘗試尋找適當的 WorkGroup size.

Data type and bit width

資料型別的使用上 Adreno 上建議使用較短的資料型別, 除了能夠減少資料存放的大小與減少頻寬, 像是對於 half (16位元浮點數) 與 float 而言, half 還提供了兩倍的計算能力.

Math functions

這裡 Adreno 上應避免除法與餘數的計算, 此外若 mul24/mad24 (24位元乘法/乘加) 足夠精準度的話, 應該儘量使用, 這主因是一個32位元的乘法計算在 Adreno 內部是透過3個指令來組成的.


後續會再探討

2017年2月11日 星期六

OpenCL Programming for Intel FPGA 初探 - III

這篇主題進入到了 OpeCL Programming for FPGA 的優化
內容主要圍繞在官方文件 - Intel FPGA SDK for OpenCL Best Practices Guide

首先必須要知道在 FPGA 上程式撰寫的快慢與計算的多寡並無直接關係
其重點在於計算間是否存在 dependency
儘管計算煩雜, 但是多數能夠平行運作, 在 FPGA 上就能更快的計算
對於 OpenCL for FPGA 的思考在於 pipeline stage 的長度與使用的 resource
下圖為官方所使用的一個簡單的範例:
儘管例子中使用了 5個運算, 但是實際的運算方式會是如上圖
而再透過 pipeline 的處理即可達到 II =1 (initiation interval) 的情況:

如上圖所示, 這麼一來即如同於 5 instruction per cycle, 能夠這樣做的原因在於對於一般的處理器而言, 僅有著有限的 register, 因此 processor 必須透過 DRAM access 來達到處理較多的資料, 而甚至因為變數數目的關係, register spilling 效應會讓 processor 為了暫存資訊更頻繁的讀寫 DRAM, 因而造成程式效能的惡化. 但是 FPGA 可藉由 Flip-Flops (FF) 來在 pipeline 的 stages 中存放這些資訊.

但是由於 FPGA 這樣的特性, 在 Kernel 之間傳遞資料也需要更好更有效率的方式, 因此 Pipe/Channel 的使用是很重要的, 碰到演算上因記憶體頻寬限制所造成的效能問題, 基本上的處理原則即是將演算再切分為多個 kernel, 並且將 memory access 部分改以如下圖的方式使用 pipe/channel, 藉此來處理.


在 Kernel 中的 loop 處理上, 必須透過優化讓 loop 的 initiation interval 達到 1, 下圖為官方文件所提供的 optimization 策略的決策圖:

至於而何為 initiation interval, 為何它這麼的重要? 下圖凸顯了若 II 不為 1 時的差異, 主要在於 loop 若非 pipelined, 效率上的 throughput 會呈倍數差異.

上述的資訊,在 Intel FPGA SDK 環境中有提供 Loop Analysis Report, 能夠以此觀察 loop 優化的情況.
從上圖得知從 Loop Analysis Report 中可以得知 unrolled 程度, 是否 pipelined, II 以及 Bottleneck 的點, 對於 Loop 撰寫的優化有很大的幫助.

除此之外, SDK 中還提供了 Area Report, 以下為一個例子
在 Area Report 上面可以觀察到下列幾點的欄位, 也就是在系列文 II 中為何要了解 FPGA Architecture.
  • ALUTs : 即為 LE 中的 用以實作 4-input 任意函數的 LUT
  • FFs : 這部分是 Flip-Flop, 也屬於 LE 中, 通常消耗在 pipeline stage 中的 register
  • RAMs : 這是 memory load/store 的行為
  • DSPs : 這是使用到的 DSP block 數量
對於在 FPGA 平台上 OpenCL Kernel 上的撰寫除了 pipe/channel 與 loop 外的其他考量即是圍繞在上述幾個點, 因此官方以 Matrix Multiplication 為例子, 提供了優化的過程的 code 與對應使用的方式, 下圖為 Matrix Multiplication 優化中的上述幾個點的變化過程:

這裡並不做細部的探討, 有興趣者請閱讀官方文件章節 1.4.2 ~ 1.4.5 , 但是對於各版本中使用的優化技巧, 簡述如下:
  • v1 : 使用 local memory 方式降低 memory access
  • v2 : 以 loop counter + 條件計算 row 值, 減少使用 % 運算. 這運算同除法會消耗大量 ALUTs/FFs
  • v3 : 對於 offset 的計算改以在 loop 中累加的方式, 取代以乘法計算, 如此可降低 DSPs 的使用量
  • v4 : 使用 per-colume 的累加方式, 最後在計算, 來降低因 data dependency 造成的 II 為 8 的 loop (增加了一個 loop 與多使用了變數, 因此 ALUTs/FFs 增加了, 但是效能變好)

對於 local memory 的使用也並不是直接使用了就沒問題, 對於 local memory 除了需要指定大小外, 還有 bank 的相關參數來避免 access stall 的發生, 若沒有足夠的資訊的話 compiler 會產生 local memory LSU 的邏輯線路來控制與管理 local memory access, 然而 LSU 的使用可能導致效率的降低.
此外 local memory 的大小使用由於 FPGA 的 memory block 的因素, 使用的大小會 rounding 為相關大小的倍數, 因此在使用的精算中必須考量到這點.

在官方文件中後續 1.6 ~ 1.9 又詳述了針對下列幾個面向的 Optimization Strategy:
  1. Single-WorkItem: 這階段為 Optimization 的根本,  因此文件除了列出的三點也提供了下圖詳盡的 workflow:
    • 依照 analysis report 來改進
    • 移除 loop 間的因 memory access 造成的 dependency
    • 良好的設計練習 
  2. NDRange
    • 限定最大的 WorkGroup 大小, 或是要求特定的 WorkGroup 大小
    • Kernel Vectorization
    • 產生多個 Compute Unit
    • Kernel Vectorization + 多個 Compute Unit
    • 依照 resource 的使用面向來優化
  3. 改進 memory access 效率
    • 優化 Global Memory Access
    • 使用 constant, local, private memory 來做計算
    • 將變數存入 private memory array
  4. 優化 FPGA Area 的使用
    • compilation 的參數
    • memory access 的考量
    • 運算上的考量
    • 資料型別上的考量
除了上述依照 compilation report 的 optimization, 在 runtime 上可能還需要使用 profiling tool 觀察實際運作的情況, 官方文件 1.5 的部分即是介紹 profiling 相關的功能如何使用, 以及提供了哪些數據.

2017年2月10日 星期五

OpenCL Programming for Intel FPGA 初探 - II

在進入針對 OpenCL for FPGA 的優化過程之前
人們必須先了解 FPGA 是如何的裝置, 與 CPU 與 GPU 在本質上的不同之處

Architecture Overview

若以低階的 Altera Cyclone V 來看的, 我們可以從其 Handbook Volume 1 看到其架構組成
由上圖可以看出 FPGA 的主體主要由三種 block 組成
  • CoreLogic Fabric and MLABs : 主要為邏輯與簡易計算的 blocks, MLAB (memory logic array block) 基本上是通用的 SRAM array, 亦可以被設定作為 RAM/ROM 的用途
  • M10K internal Memory Blocks : dual port 的記憶體 blocks, 可以存放 processor code, 用以實作查表設計, 與實作較大的記憶體應用. (像是 OpenCL 中的 local_memory)
  • Variable-Precision DSP Blocks : 可變精準度的 DSP blocks, 透過使用數量不等的區塊可以串聯出整數/浮點數精準度不同的乘法與運算單元.

與 CPU 不同的是, FPGA 的性能主要取決於上述三種 resource 的數量, 另外應用上使用的 resource 若無法壓低, 可能無法塞入 FPGA 上執行, 這是要注意的事情, 所以應用的選擇上必須注意規格, 下圖即為 Cyclone V SE SoC 內 FPGA resource 的表格:
從上途中可以觀察出一些數字是彼此相關的, 像是 18x18 multiplier 的數目與 DSP blocks 是直接成倍數關係的, M10K memory 大小 與 M10 memory blocks 數目也是如此, 這兩個部分分別對應了三種區塊的 M10K memory 與 DSP blocks, 然而第一項的 CoreLogic Fabric 呢?

Logic Elements

這部分需要從 LEs 這個數字解釋起, LE為 Logic Elements 的縮寫, 從 Altera 的解釋, LE 為其 邏輯部分的最小單位, 提供了下列功能:
  •  4 組輸入的 lookup-table(LUT) 功能, 可以實作任何 4 變數的函數
  • 可程式的 registers
  • carry chain connection
  • register chain connection
  • 多種功能的 interconnection
  • register packing, feedback
而上述的部分必須又必須從 Adaptive Logic Module(ALM) 來解釋, 下圖為 ALM 的 block diagram:

對於 ALM 官方文件是這麼描述的 "The ALM uses an 8-input fracturable look-up table (LUT) with four dedicated registers to help improve timing closure in register-rich designs and achieve even higher design packing capability than previous generations.", 而 LE 官方文件的說明為 4 組輸入, 由此可得知 ALM 為 > 2 LE 的組合, 這推斷也與官方提供的表格數字間符合.

DSP blocks

在程式中所使用到的乘法與浮點運算必須使用到 DSP blocks, 因此對於 FPGA 而言是相當重要的運算資源, DSP 提供了18b 與高精準的兩種運算模式:
此外亦單一 DSP block 提供了單精準浮點數運算以及串連4個 DSP block 形成倍精準浮點數運算

了解這些 FPGA 內部資源與用途與後續的 optimization 有很大的關聯

2017年2月5日 星期日

OpenCL Programming for Intel FPGA 初探 - I

前一陣子許多新聞都提到使用 Intel FPGA 搭配 OpenCL 來加速應用的開發
像是中興電訊(ZTE)  透過 Intel FPGA 來開發人臉識別的加速
其實 Altera 相當早就開始將 OpenCL 導入到 FPGA Programming 這塊
在 2011 年 Altera 的簡報是這樣類比的 - VHDL/Verilog 很類似"組合語言"程式設計
而 OpenCL 讓軟體開發者能夠利用硬體加速

由於這些日子來的一些例子也令我有不同的思考
開始讓個人非常想了解這樣的 Programming Model 的不同, 以及其特性與優缺點為何
因此開始投入 Intel FPGA OpenCL Programming 的探索

現今相關的軟體 Intel 都有提供在網路上, 硬體上取決於規格價格落差也不小
台灣的友晶科技有販售相關的平台, 可以自行了解與選購
但目前先單以 Intel 提供的官方文件來討論 OpenCL Programming for Intel FPGA

Programming Overview

Intel FPGA SDK for OpenCL - Getting Starting Guide: 其中對於了解階段最重要的地方在於
它圖示了整個流程的 overview
可以看出 .cl 的 kernel 透過 SDK 分兩階段編譯為不同的 .aocx, 一者為 emulation 所使用, 另一為實質在板子上的運作時所使用, 而這文件其他篇幅著墨在環境的建立上. 一方面也可以了解, OpenCL for Intel SDK 應不俱備 Online Compiler 的方式, 可能皆以 Offline Compilation 方式開發.

Intel SDK for OpenCL - Programming Guide:

Schematic Diagram

這篇文件在流程上延伸了上述的圖, 提供了 host, kernel 與 custom part 的流程
在 Getting Start 的那張圖示, 其實在解說中間 "Kernel Code Path" 在不同開發時期的產生方式, 而這張圖是講述完整的開發流程中, Host/Kernel/Custom 相關的各部分是屬於從何而來. 這張圖也揭示了, 開發過程僅有 Offline Compiler.

文件中提供了以 PC + FPGA 卡的角度來看待這個流程:
這張凸顯了, 能夠搭配多張 FPGA 卡來負責不同的部分, 透過載入不同的 FPGA binary 就可以將功能的不同部分在不同的卡上運作.

Channel and Pipe

為了 mapping FPGA 的運作方式到 OpenCL, 提供了特別的方式: Channel 與 Pipe.
事實上兩者性質很類似, 但是 Channel 為 1.x 時針對 FPGA 部分, Altera 所提出的 extension, 而 Pipe 是 OpenCL 2.0 中標準有提供的 inter-kernel 間資料串連的方式.
而對於 FPGA 中, 使用 Channel/Pipe 要思考的運作方式如下:
也就是 Kernel 與 Kernel 間以 FIFO 方式來串連與傳遞資料, Host 並不介入資料的傳遞, Kernel 也不透過對於 RAM 的讀寫來傳遞.

Manager-Producer-Consumer Working Model

而對於 Kernel 間 Buffer 的傳遞, SDK 文件中建議以 Manager, Producer, Consumer 這3個角色的 Kernel 來實作.
而透過圖中描述的四步驟周期, 來彼此協調控制流程, 並作一些 resource 的 ping-pong 使用
  1. manager kernel 送出 token set 給 producer kernel 來告知哪些記憶體區塊是給 producer 使用
  2. 在 manager 配置好記憶體區塊後, producer 對該記憶體區塊的 ping-pong buffer 寫入資料
  3. 在 producer 完成寫入動作後, 它送出同步 token 給 consumer kernel, 來告知記憶體區塊有著資料待處理. consumer kernel 然後就自該 ping-pong buffer 區塊讀取資料
    • 必須注意的地方: 當 consumer 在執行讀取動作時, 由於 FPGA 同步運行著 producer, consumer 與 manager kernel 的緣故, producer 是能夠寫入資料到其他尚未使用的記憶體位置,
  4. 在 consumer 完成讀取動作, 它釋放了該記憶體區塊, 然後送 token 給 manager kernel. 而 manager kernel 就回收該區塊以提供給 producer 使用.

Memory Partition of Global Memory - Burst-Interleaved vs Separate

Global Memory 不管對於 CPU/GPU 而言都是相當遙遠的, 必須考量頻寬與 latency, 因此對於操作上有著不同的特性, CPU 有著 cache,  GPU 仰賴著 local memory 與 many-threads 方式. 在 FPGA 上, 為了的達到較高的頻寬使用, 預設使用 Burst-Interleaved 方式, 若要自行分割也提供選項關閉, 並且在 Host Coding 中自行指定使用的 Bank.
OpenCL Library

若有常會使用的功能, 或是以 OpenCL 的方式實作較無效率的功能, Intel FPGA SDK 也提供以 OpenCL 或是 HDL 的方式實作再以 OpenCL Library 的方式導入. 而 SDK 內已經內部預先做好的 library, 開發者也能自己實作屬於自己的 library.


使用的方法如上流程圖所顯示, 實作的 OpenCL Kernel 與 OpenCL Library 透過 SDK Offline Compiler 最後產生 .aocx 的 FPGA 執行檔案.

Parallel Execution Model of AOCL Pipeline Stages

而功能的實作上, 要考量的與 CPU/GPU 上的 OpenCL 的考量不同, 對於 CPU/GPU 的實作上, 通常考量的是 SIMD 與指令使用上的考量, 能夠 SIMD 化, Exec Unit 的數目與種類, 或是否具有專屬加速指令. 但而對於 FPGA 考量的是流程上的平行度以及最後完成的長度, 再加上所使用的 resource 與 path 長短(這部分會留待第2篇), 而這些其最主要的考量為實作後整個 function 的 latency. 如下圖的 Kernel, 其從頭到尾需要 4 cycles.

2017年1月13日 星期五

CLTK - OpenCL ToolKit

臉書原始貼文
這是個 2016年8月 開始的個人專案
對於 OpenCL 有興趣者歡迎 feedback 討論
==
兩年多前, 寫了第一個關於 OpenCL 名為 clscript 的 github 專案
但連自己都缺乏感動, 妥協的設計也沒有動力去維護
近日工作上因為一件關於 OpenCL 的事情帶來一點成就感
儘管手邊的案子已經 run 了十個多月
這個案子技術上的特殊性造成 GL 不適用
當時為了方便與簡化 CL 帶來流程複雜性
給自己寫了一套 OpenCL 的 toolkit 使用
無情的是功能需求上只要客戶不買單, 那就沒有什麼好說的
因此目前還在持續努力 review 與改進之中
而加上由於類似的應用功能並不是第一個面市
相關時間與效果的要求變得很嚴苛
實作特性上客戶要求去 align 對手方案是難以避免的

而這兩週演算部門被要快速提出類似演算與整合
但要求的時間很短, 演算開發者很快也發現之前他們寫的 GL routine 不適用
由於之前知道個人有實作類似功能而詢問我
麻煩的地方是手邊的事情也蠻趕的
只好請演算開發負責人看一下我的 flow
轉寫時幫忙依樣畫葫蘆寫手機上的 code
而 CL 的 GPU kernel code 我便會抽空負責幫忙改一份適用的
在接到演算部門的code 後,
昨日上午只花了兩個小時就把事情完成了
這比我預期的短非常多
其實不管別人如何想, 一旦把事情做對做好
必要時它也會對你回報
受到了這件事的激勵
加上一直有個想實作的東西, 而類似的東西亦是必要的
於是這兩晚就以相關經驗從無到有再重新設計與撰寫
產生了這第二個 github project - OpenCL ToolKit
比起第一個 clscript, 新實作的 CLTK 個人認為實用許多
https://github.com/champyen/cltk
CLTK 有個基本精神, 希望使用 .cl 檔案能像是以 dlopen 方式使用 C 的 .so 檔
另一個 CLTK 與其他類似工具最大的不同點在於:
參數傳遞上大幅簡化
除了dimension(類似 loop 有幾層) 與 workitem 的 size (類似 for-loop 的 size)之外
使用上只要知道 kernel function 的宣告, 參數就只要如同呼叫 C function 般地將參數傳入
無需如以往地針對不同 kernel function 各自撰寫一份用以呼叫特定 function 的 glue code
code 的雜亂度會大幅降低, 能更著重於整體流程結構與在 GPU 上執行的 .cl code 的撰寫

2017年1月6日 星期五

你也可以寫 SIMD 比寫網頁還快 - III

如果沒有特別的後續想法
這篇就是系列文的最後一篇
"你也可以寫 SIMD 比寫網頁快" 的精神
不外乎就是 簡單 快速 有效

延續上兩篇在最後想要談的是搭配 clang + OpenCL vector 的進階使用方式
這裡只探討一個問題 : 使用那些基本的運算符號是否就能用上所有的 SIMD 指令?
很明顯的, 答案是不行(否則就不會有這篇啦 XDDDD)

但是如果你知道特定好用的 SIMD 指令該如何套用呢?
舉例來說 ARM NEON 有個特別的指令 VQDMULH
它的用途是將兩個 16/32bit 數值相乘後所產生的 32/64bit 數值, 取其高位的 16/32bit
以 code 表示的話:
int a, b, c;
...
c = sqdmulh(a, b);
// equal-to
int64 tmp;
tmp = a*b;
c = (int)(tmp>>32) ;
這指令對於 NEON 上實作常數的除法, 或是 fixed-point 的實作上很有幫助
這時我們可以這麼做:
int4 va = {0, 1, 2, 3};
int4 vb = {1, 2, 3, 4};
int4 vrab = vqdmulhq_s32(va, vb);
上面的範例中 int32x4_t 為 NEON intrinsics 的 data type
而基本的精神並不是什麼難以理解的事
僅是透過 pointer 作 NEON vector 與 OpenCL vector 的型別替換使用
而在之後要換回使用 OpenCL vector 可以透過一樣的方式轉回
接著我們可以透過 vec.s 觀察 clang code generation 的結果:
        adr     r0, .LCPI2_0
...
        vld1.64 {d16, d17}, [r0:128]

...
        adr     r0, .LCPI2_1
        vld1.64 {d18, d19}, [r0:128]
        vqdmulh.s32     q8, q9, q8
在此為了確認這些暫存器間的關係, 可以參考 (ARMv7) NEON registers
64b 的 (d16,d17) 即為 128b 的 q8
64b 的 (d18,d19) 即為 128b 的 q9
所以可以看到這樣的作法並沒有因此產生多餘的指令
是不是很簡單呢?

在此 "你也可以寫 SIMD 比寫網頁還快" 系列文告一段落

你也可以寫 SIMD 比寫網頁還快 - II

第一篇並沒有介紹 clang 中的 OpenCL kernel 一些基礎 型別宣告部分, 已經在上一篇出現過了, 所以這裡就從使用開始. 首先是 vector 的初始化

typedef int int4 __attribute__((ext_vector_type(4)));
typedef int int8 __attribute__((ext_vector_type(8)));
int a = 3;
int4 va = {1, 2, 3, 4}; 
int4 vb = 3;

接著是個別的 access, 下列的方式很適合做資料格式上的操作 在等號的兩邊可以用不同的表示法, 沒有需要一致:

va.x = a; 
// the below two lines are equivalent. 
vb.xyw = va.xzw; 
vb.s013 = va.s023; 
// repeat is ok 
va = vb.xyyz; 
// high and low part 
va.hi = va.lo;
va.lo = vb.hi;
// even and odd 
va.odd = vb.even;

Vector 簡單的計算如下, 可以參照 clang - vectors and extended vectors 的列表:

// scalar multiply 
va = a * vb;
// element-wise multiply
va = va * vb;
va = va | vb;
va = -va;

不同型別的 vector 轉換:

typedef float float4 __attribute__((ext_vector_type(4))); 
// format convertion 
float4 vfa = __builtin_convertvector(va, float4); 
// data reinterpret
float4 vfa = (float4)va;

接著來實戰一番吧, 下列為以 bayer format 平均 GRBG 4個像素, 轉為1/4大小灰階圖的範例

void bayer_convert(char *src, char *gray, int w, int h) 
{
    for(int y = 0; y < h; y+=2){ 
        for(int x = 0; x < w; x+=16){
            //bayer raw data fetch
            ushort8 pix00 = __builtin_convertvector(*((uchar8*)(src+x)), ushort8);
            ushort8 pix01 = __builtin_convertvector(*((uchar8*)(src+x+8)), ushort8); 
            ushort8 pix10 = __builtin_convertvector(*((uchar8*)(src+x+w)), ushort8);
            ushort8 pix11 = __builtin_convertvector(*((uchar8*)(src+x+w+8)), ushort8);

            ushort8 pix_g0;
            pix_g0.lo = pix00.even;
            pix_g0.hi = pix01.even; 
            ushort8 pix_r;
            pix_r.lo = pix00.odd;
            pix_r.hi = pix01.odd;
            ushort8 pix_b;
            pix_b.lo = pix10.even;
            pix_b.hi = pix11.even;
            ushort8 pix_g1;
            pix_g1.lo = pix10.odd;
            pix_g1.hi = pix11.odd;

            // average! so simple
            ushort8 pix_out = (pix_g0 + pix_r + pix_b + pix_g1) ;
            // write out 
            *((uchar8*)(gray+(x/2))) = __builtin_convertvector(pix_out, uchar8); 
        }
        src += w*2; 
        gray += w;
    }
}
如何? 比起看 intrinsics function 來得清楚與簡單吧
如果還想了解 OpenCL vector 的操作可以參考這篇文章
有興趣記得編譯時加入 --save-temps 來看使用的指令!!! 下一篇會介紹進階的使用方式


2017年1月5日 星期四

你也可以寫 SIMD 比寫網頁還快 - I

看到 Jim Huang 要開”從無到有自幹 boot loader 比寫網頁還快” 除了幫他打廣告外, 也趕快搭這個熱潮, 證明人人可以寫 SIMD 比網頁還快 去年寫了系列 MMX/SSE 去處理 Matrix Transpose 但是看到 SSE/AVX intrinsics 很多人大概就眼睛花了 若加上實際應用還要從 Intel 網頁查找適當的 intrinsics 會覺得難以下手 搭配適當的工具, 你也可以是 SIMD 高手! 這裡最重要的工具是 - clang clang 如同 gcc 一般提供了許多 extension 其中很重要的一點是 Vectors and Extended Vectors 這個 extension 請特別注意 link 中的 OpenCL vector, 底下的表格表示此方式提供相當全面的 operator 而 clang 中使用 OpenCL vector 這即是這裡所推荐的方式 (還可以學會 OpenCL kernel 的部份撰寫!) 首先來以 clang 方式定義 OpenCL vector 的型別
typedef int int8 __attribute__((ext_vector_type(8)));
UPDATED: 對於 GCC 支援相近語法, 其宣告為 (其中 vector_size 以 byte 計)
typedef int int8 __attribute__ ((vector_size (32)));

這裡定義了長度為 8 的 int vector type 接著我們來實作先前時做過的 matrix transpose 功能
void transpose8x8(int *src, int *dst, int w, int h){
    for(int x = 0; x < w; x+=8){
        for(int y = 0; y < h; y+=8){
            int8 row0 = *((int8*)(src+y*w+x));
            int8 row1 = *((int8*)(src+(y+1)*w+x));
            int8 row2 = *((int8*)(src+(y+2)*w+x));
            int8 row3 = *((int8*)(src+(y+3)*w+x));
            int8 row4 = *((int8*)(src+(y+4)*w+x));
            int8 row5 = *((int8*)(src+(y+5)*w+x));
            int8 row6 = *((int8*)(src+(y+6)*w+x));
            int8 row7 = *((int8*)(src+(y+7)*w+x));
            int8 tmp0, tmp1, tmp2, tmp3, tmp4, tmp5, tmp6, tmp7;
            tmp0 = (int8){row0.s0, row1.s0, row2.s0, row3.s0, row4.s0, row5.s0, row6.s0, row7.s0};
            tmp1 = (int8){row0.s1, row1.s1, row2.s1, row3.s1, row4.s1, row5.s1, row6.s1, row7.s1};
            tmp2 = (int8){row0.s2, row1.s2, row2.s2, row3.s2, row4.s2, row5.s2, row6.s2, row7.s2};
            tmp3 = (int8){row0.s3, row1.s3, row2.s3, row3.s3, row4.s3, row5.s3, row6.s3, row7.s3};
            tmp4 = (int8){row0.s4, row1.s4, row2.s4, row3.s4, row4.s4, row5.s4, row6.s4, row7.s4};
            tmp5 = (int8){row0.s5, row1.s5, row2.s5, row3.s5, row4.s5, row5.s5, row6.s5, row7.s5};
            tmp6 = (int8){row0.s6, row1.s6, row2.s6, row3.s6, row4.s6, row5.s6, row6.s6, row7.s6};
            tmp7 = (int8){row0.s7, row1.s7, row2.s7, row3.s7, row4.s7, row5.s7, row6.s7, row7.s7};
            *((int8*)(dst+(x*h)+y)) = tmp0;
            *((int8*)(dst+((x+1)*h)+y)) = tmp1;

            *((int8*)(dst+((x+2)*h)+y)) = tmp2;
            *((int8*)(dst+((x+3)*h)+y)) = tmp3;
            *((int8*)(dst+((x+4)*h)+y)) = tmp4;
            *((int8*)(dst+((x+5)*h)+y)) = tmp5;
            *((int8*)(dst+((x+6)*h)+y)) = tmp6;
            *((int8*)(dst+((x+7)*h)+y)) = tmp7;
        }
    }
}
將上列內容與先前的範例結合, 最後就是編譯了
clang -O3 -mavx -mfma -o test test.c
 以下為在 Intel(R) Core i7-3612QM 的執行結果
clang vector: 35759 us
sse: 41246 us
naive: 146310 us
這樣是不是很快呢? 甚至比之前直接用 SSE intrinsics 寫的還快!!!(灑花) 更棒的是這樣的 SIMD 撰寫, 透過 clang 是可以在各種硬體平台的 可以自己試試看用 NDK 然後跑在自己的手機看看喔!!

2014年12月18日 星期四

The era of OpenCL 2.0 is comming

Although OpenCL 2.0 spec was finalized & released in Dec 2013. But it takes almost one year for vendors to implement 2.0 runtime. In the recent months, Intel and AMD have released their SDK (Intel SDK, AMD SDK) for OpenCL 2.0.

AMD provides a series of articles about the new features of OpenCL 2.0 on the AMD Developer Blog:
OpenCL 2.0 - Shared Virtual Memory
OpenCL 2.0 - Pipes
OpenCL 2.0 - Device Enqueue and Workgroup Built-in Functions
OpenCL 2.0 - Generic Address Space and Program Scope Variables
OpenCL 2.0 - Image Enhancement

Besides these, AMD also provides a source code package of OpenCL 2.0 Samples. It is worth to take a look. You can get the key points of OpenCL 2.0 from the topics of sample package and articles. IMHO, SVM, Pipes and Device Enqueue are the most important three features among the new features of OpenCL 2.0.

==
儘管 OpenCL 2.0 規格在2013年十二月就發佈了. 但是各家廠商花了近一年實作 OpenCL 2.0 runtime. 最近幾個月Intel 與 AMD 相繼釋出各自的 SDK (Intel SDK, AMD SDK) for OpenCL 2.0.

AMD 在其 Developer Blog 還發佈了一系列關於 OpenCL 2.0 新特性的文章:
OpenCL 2.0 - Shared Virtual Memory
OpenCL 2.0 - Pipes
OpenCL 2.0 - Device Enqueue and Workgroup Built-in Functions
OpenCL 2.0 - Generic Address Space and Program Scope Variables
OpenCL 2.0 - Image Enhancement

此外, AMD 也提供了 OpenCL 2.0 Samples 的原始碼, 值得一看. OpenCL 2.0 的關鍵點能透過這些原始碼與文章的標題觀察得到. 其中 SVM, Pipe 與 Device Enqueue 是個人認為 OpenCL 2.0 新特性之中最重要的3個.


2014年8月18日 星期一

OpenCL Kernel Optimization Tips 簡報上線

這段日子工作與 OpenCL 相關
因此碰觸到了一些 Mobile 與 Desktop 的 OpenCL Runtime
面對 OpenCL 程式對不同的硬體平台做優化的過程
有許多的層面必須要考量, 因此將這些想法集結為這份 slides
日後希望有機會能update加入 example 與 case study.

2014年6月24日 星期二

OpenCL Utility/Framework 專案 - CLScript

開了自己的第一個 github project
https://github.com/champyen/clscript

這一兩年由於 GPGPU 應用的興起,
心中一直有個關於 video codec 的想法想要付諸實現
近日開始著手動工, 儘管有些地方的設計還沒頭緒
但是基本的問題還是需要解決
CLScript 這個專案因此這些基本問題而產生, 目前百廢待興, 文件與 code 還需要作進一步改進, 但是初版已可以玩一玩
OpenCL 其中一個讓 programmer 感到麻煩的地方在於
OpenCL Host Code 的撰寫很冗長,
且對於一個 function call 需要相當的前置作業
撰寫 kernel code 對應的 Host Program 是無趣的一件事
CLScript 這是個 utility/framework 層面的專案
其目的就在於簡化 OpenCL 的使用流程, 解決上述問題
讓開發者能更專注於 OpenCL 中核心的 kernel code 的開發
C/C++ framework 使用上, 建構的概念是將 .cl file 視為類似於 C library
在 test/test.cpp 中可以看到參考用法
using namespace clscript;
...
CSRuntime runtime(CS_DEV_GPU);
CSLib lib(&runtime, clFileName);
CSBuffer buf(&runtime, 4096*sizeof(cl_int));
CSWorkSize gWS(4096);
lib.exec("test", gWS, NullWorkSize, 0, &buf);

CSLib 的 exec 界面會將傳進的不定數目參數作設定與傳遞
對 C/C++ 使用者而言, 就像是呼叫一個特定的 function
另外一個 exec 界面是為了 csutil CLI tool 而設的
csutil 為直接測試 CL kernel code 的工具, 可以不用寫 Host Program 而直接測試kernel code 程式
csutil 有四大參數, 目前預設使用 GPU device
1. CL 檔案
2. 在 1. 檔案中, 所要使用的 function 名稱
3. WorkSize
     各 dimension 以 ',' 區隔, global 與 local 以 ':' 區隔, local worksize部份並非必要
4. function 所使用的參數
     * float - f:1.0
     * double - d:1.0
     * int - i:1
     * buffer - b:sz=4096,if=/dev/zero,of=out.bin
    這是最麻煩的, 設定參數又有三個sz, if 與 of(皆非必要), sz 為 buffer 大小, 未設置預設為 global worksizes 相乘, if 為用來初始化 buffer 的資料, 會讀入與 buffer size 相同大小的內容, 若無必要初始化無須指定, of為 buffer 結果的輸出, 若為 temp buffer 無須指定

以 source 中附上的 test.cl 就可以這樣使用
./csutl/csutil ../test.cl test 4096 i:2 b:sz=16384,if=/dev/zero,of=out.bin

在 ARM 平台上使用 Function Multi-Versioning (FMV) - 以使用 Android NDK 為例

Function Multi-Versioning (FMV) 過往的 CPU 發展歷程中, x86 平台由於因應各種應用需求的提出, 而陸陸續續加入了不同的指令集, 此外也可能因為針對市場做等級區隔, 支援的數量與種類也不等. 在 Linux 平台上這些 CPU 資訊可以透過...