2024年6月15日 星期六

在 ARM 平台上使用 Function Multi-Versioning (FMV) - 以使用 Android NDK 為例

Function Multi-Versioning (FMV)

過往的 CPU 發展歷程中, x86 平台由於因應各種應用需求的提出, 而陸陸續續加入了不同的指令集, 此外也可能因為針對市場做等級區隔, 支援的數量與種類也不等. 在 Linux 平台上這些 CPU 資訊可以透過 /proc/cpuinfo 取得. 而對於 CPU 不同的指令集支援去實作軟體最佳化, 是相當繁複的工作. 而這些在過去分享過的 Function Multi-Versioning (FMV) 的出現, 而大幅地簡化.

隨著時間過去, 這十年來發展迅速的 ARM 平台, 在 ARMv8 之後不斷作小幅度的翻新, 也逐漸產生類似 x86 平台上的問題. 以 A-Profile 處理架構而言從 ARMv8.0-A 一路發展到 ARMv9.4-A. 當中有著許多新硬體特性與新增指令, 有些是 core feature 而有些則是 optional, 這些也逐漸造成了 ARM CPU 平台功能性上大小不等的碎片化. 在 ARM 官網有提供了一份 "Feature names in A-profile architecture" 列表. 而這整理僅止於 ARMv9 之前. 此外更麻煩的地方是, 各大 compiler 在先前一直沒有對應支援 FMV 的功能, 如此對於通用的應用程式, 想要能夠有效使用 ARM 這些功能特性同時顧及不支援的平台, 著實是一件不簡單的事.

而事情在 2023 年中開始有了轉機, 在當時所釋出的 Clang / LLVM 16.0 開始在 ARM 平台上支援  FMV 功能. ARM 官方甚至在其系列文的 "What's new in LLVM 16" 中有特別舉例說明 FMV 的使用. 一旦能夠使用 FMV, 這對於不確定運作的目標平台的應用程式開發很有幫助. 但在當時個人第一時間找不到具有支援的 llvm toolchain, 而之後的這段時間因工作繁忙一直沒有時間再繼續做嘗試, 也就沒辦法撰寫心得. 近日回想起心中所惦記的這麼一件事, 於是特別拿了最新的 Android NDK 26d (附的是 clang 17.0.2) 來測試.

Case Study - FP16 GEMM w/ Vector Extension, Gather Auto-Vectorization

首先請安裝 Android NDK 26d 到 /opt 目錄內, 並將 /opt/android-ndk-r26d/toolchains/llvm/prebuilt/linux-x86_64/bin/ 加入 PATH 環境變數中.

由於個人在過去所分享的教材投影片中即談論過 FMV, 本文中就不再多做詳細介紹, 有需要可以參考過去的投影片, 在這裡就透過兩個實際的例子來嘗試 ARM FMV 功能, 第一個 Case 是個人常拿來作為 Compiler Vector Extension 的 Laboratory 範例的 Matrix Multiplication, 這個範例可以顯示出使用 Compiler Vector Extension 搭配 FMV 可以共伴產生廣泛支援又高效的程式碼:

typedef __fp16 fp16_16 __attribute__((ext_vector_type(16)));
#ifdef __HAVE_FUNCTION_MULTI_VERSIONING
__attribute__((target_clones("sve2", "simd")))
#endif
void gemm_vec(
    // buffer, stride
    __bf16 *a, int sa,
    __bf16 *b, int sb,
    __bf16 *c, int sc
){
    fp16_16 vb[16];
    for(int y = 0; y < 16; y++){
        vb[y] = *((fp16_16*)(b + sb*y));
    }
    for(int y = 0; y < 16; y++){
        fp16_16 vc = *((fp16_16*)(c + sc*y));
        fp16_16 va = *((fp16_16*)(a + sa*y));
        for(int x = 0; x < 16; x++)
            vc += va[x]*vb[x];
        *((fp16_16*)(c + sc*y)) = vc;
    }
}

這個範例中, 為了能產生較大的 code generation 的差異, 個人選擇使用 float16 的資料型別. 主要是因為 ARMv8 並非預設支援 fp16, 而是到了 ARMv8.2 以 optional extension 來提供 (而預設支援 SVE2 的 ARMv9 是預設支援的). 將上述這段程式令存為 arm_gemm.c 之後搭配下列指令編譯:

$ aarch64-linux-android34-clang -O3 --save-temps -c arm_gemm.c
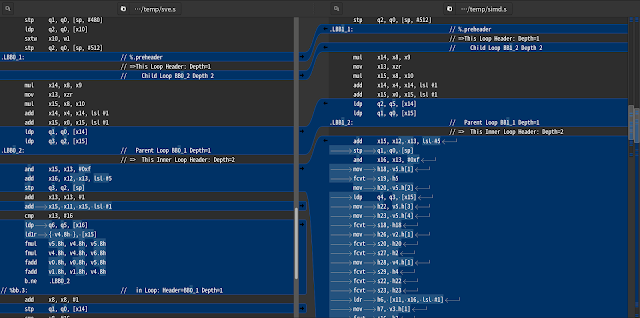
如此當中可以觀察產生的 arm_gemm.s 檔案, 當中有 gemm_vec._Msve2 與 gemm_vec._Msimd 兩段程式, 以及用來做選擇的 gemm_vec.resolver, 可以觀察 sve 版本直接使用支援 fp16 的 fmul, 而 AdvSIMD 版本當中不斷使用 fcvt 指令來處理浮點數轉換, 行數落差也相當的大.


接著的第二個範例中是透過 auto-vectorization 來實際展示 ARM 官網上的 "Auto-vectorization examples" 內關於 Scatter and Gather 的部份, 而為了能確實透過 clang/llvm 的組合產生使用 gather 指令, 該段程式經過稍加修改後程式碼如下:

#include <stdint.h>
#ifdef __HAVE_FUNCTION_MULTI_VERSIONING
__attribute__((target_clones("sve2", "simd")))
#endif
float gather_reduce(float *restrict data, int *restrict indices, long c)
{
    float r = 0;
    #pragma clang loop vectorize(enable)
    for (long i = 0; i < c; i++) {
        r += data[indices[i]];
    }
    return r;
}

將上述這段程式令存為 arm_gather.c 之後搭配下列指令編譯:

$ aarch64-linux-android34-clang -O3 --save-temps -c arm_gather.c
同樣地, 透過觀察編譯過程中產生的 arm_gather.s 檔案, 當中有 gather_reduce._Msve2 與 gather_reduce._Msimd 的兩段程式碼, 從中可以看到 SVE 的版本的 gather_reduce function 確實有使用 L1DW 這個 SVE 指令集所專屬的 gather 指令.

ARM Feature List

最後談談 ARM 與 x86 平台在 FMV 在實務使用中不同的地方. 在 ARM 平台的 FMV target 僅止為 feature, 而 x86 FMV 的 target 則能夠是特定的 CPU arch, 特定的 CPU core 或是指定的 ISA. 那麼具體來說在 ARM 上 FMV 有哪些 feature 可以選擇呢? 可以參考ARM 這份 ACLE 文件, 當中有提供對應的 feature 列表與在指定 FMV target 的名稱, 另外如以往的 FMV target 的使用, 這些 feature 是可以透過 + 來合併選擇使用的, 像是 "sve2+memtag" 來合併使用 SVE2 與 Memory Tagging, 同樣地一如以往 "default" 表示的是基本的指令集, 產生完全不會使用到 feature 的 code.

2023年11月12日 星期日

Chisel 學習筆記 - Scala 與 Chisel 基礎語法

標題為筆記, 但這篇比較屬於心得

延續上一篇的環境建立, 這次計劃藉由 Jserv 最新的課程安排來學習 Chisel, 當然個人目標是能夠按照 Jserv 的課程規劃在期限之內完成 Lab 3, 由於個人並非 digital designer (現在這年紀也算老貓學新把戲...), 因此對於 chisel 的一切也是從基本開始, 目前計劃於一週內按照 Chisel Bootcamp 的章節完成 Chap 0 ~ 3 的所有內容. (Chap 4 部份在後續會依照進階需求選擇回來看)

週末花了點時間把 Chap 0 ~ 2 的說明研讀完, code block 的操作也跑過一次流程, 另外是在 try and error 下完成當中的所有 exercise & test. 個人覺得 Chisel Bootcamp 多少是面向俱備 Verilog / HDL 有些許基礎的人. 儘管無基礎並不會造成學習的困難, 但多少難以體會 Chisel 相較之下的優點與強項.

基本上Chap 0 ~ 2 的重點其實並不多

  • Chisel 的特性
  • Scala 的基本語法
  • 建構於 Scala 之上的 Chisel DSL
  • 電路的基本: module, combinational, control & sequential logic
  • 除錯與測試方式

由於並非第一次學習建構在另一語言的 Domain Specific Language. 過往學習 Halide 的過程就是這樣的一個經驗. 然而與先前 Halide 不一樣的地方是 Halide 所依附的 C++ 個人有所基礎, 但是對於 Scala / Chisel 這樣的組合卻是完全從頭學起. 而這大概有幾個面向是需要反覆思考與刻意練習的.

第一個主要的點在於 Value 與 Typing System, 類似於 C++ 與 Halide 有著各自的 value & typing system, C++ 主要用在撰寫與控成 Halide code 的流程, Halide 體系著重在產生 target code 上. Scala 與 Chisel 也有各自的 value & typing system. Scala 也是用在撰寫 Chisel 主體與流程上, Chisel 是用以定義 hardware 使用到的 module 與產生 instance. Chap 1 ~ 2.1 強調分清楚 Scala 與 Chisel 的 value & typing system 確實是很重要的一件事.

第二個是 Chisel 的實作撰寫必需了解的 3 個階段 - circuit generation, circuit simulation 與 testing. (Halide 也有著類似的階段, 甚至都使用 Generator 這樣的名稱) Scala 與 Chisel 在使用上容易搞混的是 generation, Scala 是讓 code generation 能透過參數化來產生對應不同的 circuit (按照教學說法, 這是 Chisel 強大的地方). 因此這些都是在 compile time 決定的, 而 Chisel 的撰寫則是決定了 circuit generation 的結果. 對於一些 if / else 的思考必須區隔希望影響的是 compile time 的行為抑或者是 runtime 時的所需. (習題上來說, 觀察前後輸入的 data type 就可以快速反應)

儘管這些並不是什麼艱深難懂的心得, 然而困難的點是在熟悉與快速應用 Scala / Chisel. 重要的還是需要刻意練習來讓思維方式有著正確的對應. 若儘只是研讀一番並不足以深刻體會, 或是習得實務上的撰寫能力. Chisel Bootcamp 的作業與測試非常值得一一花時間下去練習. 藉由這些能夠一次次找到認知錯誤的地方或是盲點. 個人認為能嘗試完成 2.2 Arbiter, 2.3 Finite State Machine 與 2.5 FIR Filter Generator 這三個 exercise 應符合了基本要求. ( 2.2 中提供的 Cheatsheet 第一頁對於閱讀內容與作業相當有幫助)


2023年11月10日 星期五

Chisel 學習筆記 - 環境建立

近日 Jserv 在期 2023 年度課程中仿效 UC Berkeley 的課程, 計劃透過課程 Lab 引導學生學習 Chisel 來實作 RISC-V 核心

為此他高度簡化了原本 UC Berkeley 的教程, 建立一個新的 Lab, 目標是帶領學生實作 5-stage pipeline RISC-V processor

在 Lab 3 的 Hackmd 頁面上可以看到幾個章節:

  • Install sbt
  • Chisel Tutorial
  • Chisel Bootcamp & Chisel 介紹
  • Single-cycle RISC-V CPU

這篇文章的重點是放在建立可攜式的 Scala Build Tool 環境, 由於並非每個人都想在日常使用環境與這類開發環境混在一起, 希望儘可能保持系統的單純與乾淨程度. 所以還是選擇透過 Apptainer 這個 rootless 的 container 技術來建立環境. Apptainer 的安裝相當簡單, 在官網的 Installation 頁面可以找到個別 Linux Distro 的安裝方式. 至於 Apptainer 的使用方式則可以參考個人先前的介紹文.

對於 SBT 於 Linux  上的安裝, 在官網提供了兩個方式, 分別是透過 SDKMAN 與 debian-based repository 的方裝方式, 由於使用 apptainer, 所以我們可以選擇透過 debian-based repository 的方式.

經嘗試後, 下列為建立 apptainer sandbox 的 script

#!/bin/sh export SANDBOX=chisel_env
rm -rf $SANDBOX
rm -rf $SANDBOX-overlay
apptainer build --fakeroot --sandbox $SANDBOX docker://ubuntu:latest
apptainer exec --fakeroot --writable $SANDBOX apt update
apptainer exec --fakeroot --writable $SANDBOX apt dist-upgrade -yqq
apptainer exec --fakeroot --writable $SANDBOX apt install openssh-client openjdk-11-jre-headless openjdk-11-jdk-headless ca-certificates-java apt-transport-https curl gnupg -yqq
apptainer exec --fakeroot --writable $SANDBOX sh -c "echo 'deb https://repo.scala-sbt.org/scalasbt/debian all main' | tee /etc/apt/sources.list.d/sbt.list"
apptainer exec --fakeroot --writable $SANDBOX sh -c "echo 'deb https://repo.scala-sbt.org/scalasbt/debian /' | tee /etc/apt/sources.list.d/sbt_old.list"
apptainer exec --fakeroot --writable $SANDBOX sh -c "curl -sL 'https://keyserver.ubuntu.com/pks/lookup?op=get&search=0x2EE0EA64E40A89B84B2DF73499E82A75642AC823' | gpg --no-default-keyring --keyring gnupg-ring:/etc/apt/trusted.gpg.d/scalasbt-release.gpg --import"
apptainer exec --fakeroot --writable $SANDBOX chmod 644 /etc/apt/trusted.gpg.d/scalasbt-release.gpg apptainer exec --fakeroot --writable $SANDBOX apt update
apptainer exec --fakeroot --writable $SANDBOX apt install sbt graphviz -yqq mkdir $SANDBOX-overlay
# testing sbt
apptainer exec --overlay $SANDBOX-overlay $SANDBOX sbt --version

完成後可以看到如下的字串

sbt version in this project: 1.9.7
sbt script version: 1.9.7

後續使用方式並不難, 只要提供 overlay 與 sandbox 的路徑即可, 所以可以宣告絕對路徑來使用, 假設 sandbox 與 overlay 的目錄為 ~/workspace/ca2023/ 下, 那麼可以如下先建立環境變數:

$ export SANDBOX_PATH=~/workspace/ca2023/chisel_env
$ export SANDBOX_OVERLAY=~/workspace/ca2023/chisel_env-overlay

如此可以透過下列指令在 chisel-tutorial 來執行 sbt run

$ apptainer exec --overlay $SANDBOX_OVERLAY $SANDBOX_PATH sbt run

當然也可以先執行下列指令, 得到建立環境的 shell 後切到 chisel-tutorial 目錄執行 sbt run

$ apptainer shell --overlay $SANDBOX_OVERLAY $SANDBOX_PATH
Apptainer> cd chisel-tutorial/
Apptainer> sbt run

[info] Loading project definition from /home/champ/workspace/ca2023/chisel-tutorial/project
[info] Loading settings for project chisel-tutorial from build.sbt ...
[info] Set current project to chisel-tutorial (in build file:/home/champ/workspace/ca2023/chisel-tutorial/)
[info] running hello.Hello
[info] [0.001] Elaborating design...
[info] [0.054] Done elaborating.
Computed transform order in: 208.3 ms
Total FIRRTL Compile Time: 261.5 ms
End of dependency graph
Circuit state created
[info] [0.000] SEED 1699679987261
test Hello Success: 1 tests passed in 6 cycles taking 0.008084 seconds
[info] [0.002] RAN 1 CYCLES PASSED
[success] Total time: 2 s, completed Nov 11, 2023, 5:19:48 AM
Apptainer>

如此就建立好可以使用的 container, 需要清除也很簡單, 刪除 chisel_env 與 chisel_env-overlay 即可


最後對於 Chisel 語言的學習提供的材料是 Chisel Bootcamp, Lab 3 中提供的是 GitHub 上面的兩個方式 - Docker 與 Local Install. 

然而 Chisel Bootcamp 的安裝設定, 並不是 Lab 的主要重點, 個人最建議的方式是直接使用在其 GitHub 主頁面上的 Get Started 一段中提供的 "Try it out HERE! No local installation required!", 如此可以省下安裝設置 Docker 或是 local 安裝 jupyter 碰到各種問題的時間.

2023年11月5日 星期日

OpenCL 1.2 之後(個人觀點中)重要的 feature 與 extension

最近因工作緣故, 而看到了使用 subgroup 特性的實作, 在第一時間個人難以解讀程式碼的目的與原意,  後來看了原始實作與擴充功能的說明文件才得知 subgroup 的功能特性為何. 主要因為個人對於 OpenCL 2.x 印象僅停留在 Shared Virtual Memory. 然而事實上 OpenCL 2.0 到 OpenCL 3.0 這段期間依然有數個實用的功能特性與擴充 對於 OpenCL 3.0 而言, 這些 2.0 以後加入的新 features 與 extensions 都屬於 extension. 因此可以到 The OpenCL™ Extension Specification 頁面一一查看. 以下列出個人覺得實用的 extensions:

Creating a 2D Image From A Buffer

許多時候人們很希望能透過 vload / vstore 來存取 buffer, 又希望能夠使用 GPU 的 texturing unit. 在 OpenCL 1.x 的時代, 通常是透過 ION buffer 來重複 mapping 到 Buffer 與 Image, 並且傳入對應的 kernel 中使用. 基本上這需要 GPU vendor 確認 cache coherency 的問題, 甚至提供對應的 driver 支援. 在 OpenCL 2.0 中將類似功能成為 core feature, 也就是 OpenCL 2.0 中是必要的存在. 透過 cl_khr_image2d_from_buffer 這個 extension, 可以先配置 Buffer 後再以此 Buffer 來建立 Image. 一開始提到相同目的.

Subgroups

儘管 OpenCL 中提供了 Global 與 Local work size 來對整體工作做切割, 而 Local work size 另一個重要的意義是對應的 workgroup size 是能作同步的最小單位. 在 OpenCL 2.1 中新增了這個 core feature. 在 Workgroup 中能夠再切分一個 1D 的 subgroup, 除了 subgroup 層及的 barrier 做同步外, 也提供了 3 個種類的 kernel function: reduce_op, scan_exclusive_op 與 scan_inclusive_op. 這些 operation 對於 reduction 與 integral 這兩類原本 OpenCL 不適合應付的計算提供了有效的介面, 讓 device 能夠使用硬體支援來處理這類的計算.

Mipmaps

在 OpenGL 中支援以硬體產生 Mipmaps 來做 texturing. 可以避免 aliasing. 這裡應該是同等的結構. 但除了做原本 antialiasing 用途外, 不知是否有機會利用這個 pyramid 結構來做 CV 應用.

Integer Dot Product

OpenCL 中原本只支援 float / double 型別的內積 (dot product), 然而現今 NN 應用中 8-bit integer dot product 的需求相當大. 這個 extension 有效的提供了對於 8-bit dot product 硬體加速的介面. 理論上透過 multiplication 搭配 subgroup 就可以得到相同結果, 但若支援此 extension 且俱備硬體加速, 可以得到更高的 computation throughput.


當然 OpenCL 2.x 系列還是有其他像是 SVM, device-side enqueue 與 Pipe 的功能, 有時間再來寫程式並撰文說明這些功能的實際的應用.


2023年10月14日 星期六

OpenCL 在 2023 相關的研讀資料 / 工具

儘管近年已經沒有密集使用 OpenCL

但最近同仁因工作而起的 OpenCL 相關實務討論還是令我相當感興趣與熱衷

雖然 OpenCL 在現今已不是各家密集發展的重點技術標準

然而在有實際應用場景需求, 但沒有更好的新標準, 儘管各家計算硬體開發商缺乏合作默契的情況之下(特別是 Mobile 平台), 繼續良好支援 OpenCL 似乎是實務上的一個共識了

這篇主要的目的是統整一下在 2023 的今日要著手 OpenCL 有哪些資料可以研讀

書籍

由於 OpenCL 3.0 標準是以 OpenCL 1.2 為基底, 因此過往的 OpenCL 圖書內容都還是相當實用. 至於談到 OpenCL 2.0 標準後新增的部份 (個人覺得現今 OpenCL runtime 逐漸完備下 device-side enqueue, subgroup 以及 pipe 都可以把玩一番), 而目前僅有一本參考書目可以研讀 - "Heterogeneous Computing with OpenCL 2.0", 這本書被標為 3rd edition 的原因是前面有著兩版談論 1.1 與 1.2 的兩個版本

標準與相關資訊

OpenCL 的制定組織統整了 OpenCL 相關的資源連結 - OpenCL Resource Guide

若要查找標準相關的資訊, 另外是相關的程式資源, 這裡算是參考資料翻找的入口

各 GPU vendor 提供的 OpenCL Programming Guide

由於各家還是有自己的 OpenCL runtime 與 compiler 實作, 因此在使用與實作 OpenCL 程式還是有各家平台在 Host 與 Device 中需要注意的一些細節. 這裡整理了各家目前提供的文件.

Intel

OpenCL Developer Guide for Intel® Processor Graphics

AMD 

ROCm OpenCL Programming Guide (這是 archive.org 在去年底的備份, 其實不清楚為何 AMD 再最新的文件中將 OpenCL 的部份移除)

Nvidia

NVIDIA OpenCL Best Practices Guide Version 1.0

NVIDIA OpenCL SDK Code Samples

Qualcomm

Qualcomm Snapdragon  Mobile Platform OpenCL General Programming and
Optimization
(原名 Adreno OpenCL Programming Guide)

ARM

Mali GPU Bifrost Valhall OpenCL Developer Guide

Mali Midgard OpenCL Developer Guide

Imagination

A quick guide to writing OpenCL kernels for PowerVR Rogue GPUs (Imagination 事實上是有 OpenCL performance optimization 相關文件, 只是比較可惜的是僅會對客戶提供)

工具

與 Optimization Guide 類似, 由於 GPU hardware counter 並沒有一致性的標準與介面, 所以這部份比較可惜的是必須仰賴各家的 Offline Compiler 與 Profiler

Intel

Intel® Graphics Performance Analyzers

Ahead-of-Time Compilation for GPU

AMD

Radeon GPU Profiler

Radeon GPU Analyzer

Nvidia

NVIDIA Visual Profiler

NVIDIA CUDA Compiler (NVCC)

Qualcomm

Snapdragon Profiler

Adreno GPU SDK

ARM

Mali Graphics Analyzer

Mali Offline Compiler

Imagination

PVRTune

PVRSHADEREDITOR


2023年5月25日 星期四

SIMD Programming Guide 簡報上線

今年定下的年度目標之一是建立比較完整的 SIMD 教學資源, 原本預計撰寫三個部份, 最後完成是有四個部份:

  • Part 1 - 透過 compiler 跨硬體架構平台的 compiler vector extension 來撰寫 (architecture-independent) SIMD 程式
  • Part 2 -講述一般而言 SIMD 指令有哪些類型, 開始導入 Arch-dependent Intrinsics, 並提供 NEON 與 SSE 的具體使用例子, 與 Lab2 的說明
  • Part 3 - SIMD optimization 的一些基本步驟, 套用 SIMD ILP 的兩種基本面向, 並各自以 Gaussian 5x5 與 4x4 SAD 為舉例, 最後是 fuse / tiling / sliding-window / prefetch 等初步的進階技巧
  • Part 4 - 講述 SIMD 的弱點也就是 SIMD 不擅長或是缺點的部份


2022年8月7日 星期日

Halide Introduction 2022 簡報上線

近日應公司同仁邀請分享對 Halide 做介紹
於是基於 2019 的投影片做一點整理並增加一點常被詢問的資訊

2022年6月1日 星期三

The Story After HEVC 簡報上線


近日應於政大任教的朋友於其課程中分享心得的 "The Story After HEVC" 簡報上線


 歡迎不吝指教

2022年4月28日 星期四

初探 clang 14.0 中的 Matrix Type

在先前 Clang 14.0 的文章中提到 Clang 14.0 新增了 Matrix Type, 出於個人的好奇, 於是就開始動手玩了一下, 這裡先說結論, Clang 14.0 中的 Matrix Type 還是開發階段, 尚不太好操作. 這裡嘗試使用 Matrix Type 的應用是 Tiled Matrix Multiplication.

比較基準的 vector type 實作

首先是先前已經以 Clang Vector Extension 所實作的 float 型別 8x8 矩陣乘法

typedef float float8 __attribute__((ext_vector_type(8)));
void gemm_vec(
    // buffer, stride
    float *a, int sa,  
    float *b, int sb,
    float *c, int sc
){
    float8 vb[8];
    for(int y = 0; y < 8; y++)
        vb[y] = *((float8*)(b + sb*y));
    }
    for(int y = 0; y < 8; y++){
        float8 vc = *((float8*)(c + sc*y));
        float8 va = *((float8*)(a + sa*y));
        for(int x = 0; x < 8; x++)
            vc += va[x]*vb[x];
        *((float8*)(c + sc*y)) = vc;
    }
}

以 matrix type 實作的過程

接著是參考 Clang Matrix Type 的說明嘗試定義 8x8 的 Matrix Type:

typedef float float8x8 __attribute__((matrix_type(8, 8)));

首先值得一提的是定義的 matrix type 所宣告的變數, 類似於 vector type 內作為 1D array, matrix type 變數能作為 2D array 的語法來存取個別數值. 這裡定義好 float8x8 型別之後, 必須宣告變數並將 2D 資料載入, 於是會發現文件中並沒有說明如何載入資料! 這部份必須參考目前的 Draft Specification, 目前 Clang 僅支援 3 個 function:

  • M2 __builtin_matrix_transpose(M1 matrix)
  • M __builtin_matrix_column_major_load(T *ptr, size_t row, size_t col, size_t columnStride)
  • void __builtin_matrix_column_major_store(M matrix, T *ptr, size_t columnStride)

總之, 資料載入的方式有了, 那麼 column major load /store 的意義為何? 這主要是載入資料的順序, 參考 Wikipedia 關於 Row- and column-major order 頁面的圖解, 可以得知對於 column major load 的意義在於:

有點不太理解 clang 第一時間所支援的竟然不是 row major load / store. 然而使用 column major load store 的結果是所得到的 matrix 為原本所需的 transposed matrix. Anyway, 由於我們只有這個讀取方式, 所以我們先讀取原先 function 中的 a, b, c 矩陣:

float8x8 ma, mb, mc;
ma = __builtin_matrix_column_major_load(a, 8, 8, sa);
mb = __builtin_matrix_column_major_load(b, 8, 8, sb);
mc = __builtin_matrix_column_major_load(c, 8, 8, sc);

然而我們還是可以動些手腳來達成原本的 Tiled Matrix Multiplication, 首先我們原本要計算的資料為

C += A x B

然而這當中的 A, B, C, 透過 __builtin_matrix_column_major_load 所得到的已經是 transposed matrix (這裡我們用 A', B', C' 代表), 因此我們可以透過預先透過 __builtin_matrix_transpose 來轉回 A, B, C. 正確計算後能再轉回原先的 column major matrix 來存回正確的數值. 

ma = __builtin_matrix_transpose(ma);
mb = __builtin_matrix_transpose(mb);
mc = __builtin_matrix_transpose(mc);
mc += ma*mb;
mc = __builtin_matrix_transpose(mc); //transposed again
__builtin_matrix_column_major_store(mc, c, sc);

這裡使用了四次 __builtin_matrix_transpose, 僅僅是為了達到計算上正確的 C=AxB, 由於在回存時必須保持 transposed 狀態, 所以如果計算時能產生對應 C' 的資料即可, 於是我們可以這麼計算:

C'+=B'xA'
於是我們整個實作就可以簡化如下:

void gemm_vec(
    float *a, int sa,
    float *b, int sb,
    float *c, int sc
){
    float8x8 ma, mb, mc;
    ma = __builtin_matrix_column_major_load(a, 8, 8, sa);
    mb = __builtin_matrix_column_major_load(b, 8, 8, sb);
    mc = __builtin_matrix_column_major_load(c, 8, 8, sc);
    mc += mb * ma;
    __builtin_matrix_column_major_store(mc, c, sc);
}

最後是編譯時要注意, clang 必須加入 -fenable-matrix 這個參數

以這種實作搭配 AVX2 在 Intel Core i5-8350U 測試, 對於 naive, vector type 與 matrix type 來測試用於兩個 512x512 matrix multiplication 的效能

因此 single thread 來執行 naive, vector type, matrix type 三種實作的時間分別為 129.9ms, 26.0ms, 27.0ms. 因此以 matrix type 可以得到十分接近的 vector extension 的性能, 但是實作上相當簡潔易懂.

到此許多人應該會關心 clang 未來是否支援 row-major 的形式? 個人認為是會的, 首先 Intel AMX 指令集所使用的即是 row major 的 load/store. 再者是在 2020 年 LLVM 開發者大會中 "Matrix Support in LLVM and Clang" 的演講的倒數第二張投影片 "Remaining Work" 明確標示了 Row-major support.


使用後個人想提的幾個 idea:

定義 matrix 的同時, 應同時定義出 row 與 column 的 vector 型別, 目前不知如何取得定義語法, 這裡暫時以 ".row_vec" 與 ".col_vec" 來表示. 也就是說當我們定義了:

typedef float float8x8 __attribute__((matrix_type(8, 8)));

那麼可以用此定義一併定義出對應用在 row 與 col 的 vector type (或是分開定義但是 compiler 偵測 vector length):

float8x8.row_vec vrow, vrow2;
float8x8.col_vec vcol, vcol2;

如此可以合併使用 vector extension 與 matrix type 來處理 row major 或是 column major 的數值設定:

float8x8 mat;
...
vrow = *((
float8x8.row_vec*)ptr_row);
vcol = *((float8x8.col_vec*)ptr_col);
mat.row[1] = vrow;        // set a row
mat.col[2] = vcol;        // set a column

另外可以做 row vector 與  column vector 與矩陣相乘運算:

float8x8 mat;
...
vrow = *((
float8x8.row_vec*)ptr_row);
vcol = *((float8x8.col_vec*)ptr_col);
vrow2 = vcol*mat;
vcol2 = mat*vrow;


2022年3月17日 星期四

Clang 14.0 將增加 vector extension built-in functions

由於 LLVM / Clang 14.0 發佈的接近, 近日就花了點時間看一下對於 vector extension 是否有相關的更新. 目前在 Clang 官方網站文件上已經可以看到.

Clang 14.0 中最令人振奮的莫過於新增的兩個部份

  • Vector Builtins
  • Matrix Types

Vector Builtins

vector builtins 主要能提供 compiler 明確使用對應指令來加速, 而這些不容易透過 C operator 來表示, builtins 分為兩類 elementwise builtins 與 reduction builtins 

Fig. 1 - Elementwise Builtins 列表

Elementwise Builtins 本質上就是 Per-lane operation, 像是 __builtin_elementwise_max, 事實上透過先前分享過的 Clang ternary operator 就可以實作, 也就是說下列的 ternary operation:

vc = va > vb ? va : vb;

基本上等同於:

vc = __builtin_elementwise_max(va, vb);

事實上 elementwise builtins 並不限定於套用在 vector type, 基本的 scalar types 也可以.

Fig. 2 - Reduction Builtins 列表

Reduction Builtins 主要用在可以快速從 vector 中算出單一數值的結果, 舉凡像是總和(sum), 最大值(max)與最小值(min) 等等. 在 Clang 中還有特別的 - 所謂水平方向 AND / OR / XOR. 這對一些特別的應用很有幫助.

Matrix Types

由於現今新一代的 CPU 都加入了對於 matrix 操作加速的指令(Intel 的 AMX, ARM 的 SVE Matrix Extension 與 SME), 因此 Clang 加入 matrix type 也有助於更有效去使用這些.

在 Clang 中可以透過下列方式定義與使用 Matrix:

Fig. 3 - Clang Matrix Type 定義與使用範例

透過定義 Matrix Type, 能夠直接支援基本運算操作. 目前官方說明與範例中並沒有顯示與 vector 的互動. 但以目前的型態撰寫相關應用已便利不少.


2022年3月12日 星期六

ARM SVE 研讀筆記 Part-6 - Extended floating-point horizontal reductions 與 SVE/SVE2 optionals

這篇是系列文的最後一篇, 主要談兩個列於標題的項目.

Extended floating-point horizontal reductions

在討論 Extended floating-point horizontal reduction 時必須要知道 ARM 在 ARMv8 時增加了一些 instruction / intrinsic functions. 從官方的 ARM NEON intrinsics reference 可以查找出這次要討論的主角 vaddvq_f32 / vaddvq_f64. 這兩個 intrinsics 的目的在於把向量中所有 float / double elements 加總回傳. 雖然相當簡單, 但是 floating-point 的操作對於驗證有個很重要的議題 - order. 透過 reference 查找出此兩者, 可以得知在 ARMv8 是透過 FADDP 指令來達成的. 這個指令是將相鄰的成對數值相加. 從 vaddvq_f32 可以看出是利用兩個 FADDP 指令達成加總的目的. 這樣做的好處是可以減少 instruction latency. 然而這樣的次序在驗證上需要特別處理.

Fig. 1 - SVE 同時提供了 floating-point  in-order 與 tree-based reduction 處理

在 SVE 中同時提供了 in-order (由左至右) 與 tree-base (成對相加) 的作法. 如此可以取決於效能還是結果驗證從這兩者選擇. 在 ARM C Language Extension 可以看到下列的段落:

Fig. 2 - 兩種不同順序浮點數加總的 SVE intrinsic function

依照先前說明轉換 NEON intrinsics 至 SVE intrinsics 的規則, 可以輕易的了解 NEON 中的 vaddvq_f32 對應的 SVE intrinsic function 為 svaddv_f32. 也映證了原有的方式是基於效能的 tree-based. 而新增加的是由左至右的作法是 svadda_* 系列. 而由於 in-order 的特性, 在執行上也較為沒有效率, 從 Arm Cortex-X2 Core Software Optimization Guide 可以看出 FADDP 與 FADDA 兩者有著相當大落差的 exec latency (也就是需要幾個 CPU cycle 才能產生所需結果)

SVE/SVE2 options

在 ARM 制定 SVE 的過程中, SVE 與 SVE2 各自有其核心目標, 這篇主要是說明 SVE 到 SVE2 制定上功能上的演進. 搭配 ARM A-Profile 網站與 ARM C Language Extension 文件閱讀會比較有感.

Fig. 3 - SVE Base functions

SVE base 中建立了 SVE Programming Model 的基本需求. 基本上大部分的 intrinsic functions 都會落在這個類別.

Fig. 4 - SVE optional

在 ARMv8.6 提出時對於 SVE 增加對 BFloat 16 與 GEMM 的支援. GEMM 上主要是能以 vector 來完成 8x2 & 2x8 (8bit) 或是 2x2 (floating-point) 的 Matrix Multiply. 詳情建議閱讀官方 Blog 介紹文章. 值得一提的是 SVE option 的提出時間點 (ARMv9.1) 比 SVE2 推出的時間(ARMv9.0)還晚.

Fig. 5 - SVE2 Base 新增功能列表

將 SVE 列為核心功能是在 ARMv9.0 的事情, 當時是以 SVE2 的版本加入. 相較於一開始與 Fuji 合作於 A64FX 超級電腦核心的 ARMv8.2 中採用的 SVE 已有相當的時日. SVE2 很大的部份在補足 SVE 設計上的缺漏. 特別是在 SVE 中缺少的 data width widening & narrowing 的運算. 另外像是 while loop control 對於 decremental counter 的支援, 複數與大數的支援等等 ...

Fig. 7 - SVE2 optional 增加的功能

最後是 SVE optional functions, 這一部份主要集中於 Crypto 應用的部份. 透過這些指令可以加速 AES-128, SHA-3  與 SM4 的加解密應用. 另外是一個較大的 extension - SME. SME 基於 SVE / SVE2 提供了更有效處理 Matrix 操作的功能. 除了提供 outer-product engine 外也額外增加新的執行模式 - "Streaming Mode". 軟體實作可以藉由使用這個模式來支援更大的 vector length 與達到更高的 throughput. 詳情可以參考 ARM 官方 SME 介紹文.

至此大略介紹了 ARM SVE/SVE2 的功能與相關 extensions. 後續希望有機會在撰寫相關實務文章.

2022年3月4日 星期五

ARM SVE 研讀筆記 Part-5 - Gather & Scatter

在 Processor 中開始出現 Gather and Scatter 相關指令之前之前, 許多 Hardware IP 就俱備有 Gather & Scatter DMA. 像是由於影像處理的需求, 一些 DSP 就俱備 2D DMA, 許多商業市場上的應用 DSP 都俱備這種能力(e.g: CEVA, Cadence Tensilica, Synopsys Arch ...), 而因為近年的 ML 對於 Tensor 操作的部份, 所以像是 >= 3D 或是俱備更多操作彈性的 DMA 在這幾年之中都出現了. 而 ARM SVE 迎合這個發展方向與相關的應用, 在推出時也針對 vector loading 做了補強, 增加了 Gather & Scatter 的相關指令.

Fig. 1 - Gather & Scatter 示意圖

首先必須說明 Gather 與 Scatter 的意義為何, 這是兩個對應的動作. 所謂的 Gather 是透過硬體所提供的規則將指定不連續的資料於 load in 後整併為單一個 vector 的動作; 而 Scatter 則是一個反向的行為, 也就是將所指定的 vector 中的資料, 透過規則所指定的方式, 將資料存放到各個不連續的記憶體位置中. 以這樣的方式看來 ARM NEON 原本就俱備的 vld2/vst2, vld3/vst3 與 vld4/vst4 事實上也是一個規則固定的 Gather / Scatter 退化型操作.  然而 vldN / vstN 因為規則太過固定, 因此實用性還是有所侷限. (話說 vld3 其實相較 x86 的 SSE/AVX 對於 3-channel 的資料, 像是 RGB/YUV 等等的操作真的方便不少)

Fig. 2 - LD1 scalar base, vector offset 的例子

在 ARM 官方的文件 ARM C Ext. for SVE 中, 對於 Gather / Scatter 並非是匯整在同一個章節, 相對地這些是分散在 6.2 Loads 與 6.3 Stores 兩節中. 對於 Gather / Scatter 中提供不連續記憶體位置的方式有三:

  1. base only: 也就是每個 lane 使用對應 lane 指定的 address
  2. base + offset: 每個 lane 的 address 計算方式為: base + offset (in bytes) 的方式
  3. base + index: 每個 lane 的 address 計算方式為: base + index (of element) 的方式, 也就是位置計算是 index * sizeof(element)

Fig. 3 - AoS 與 SoA 的不同考量示意

而 2. 與 3. 當中的 base  + offset/index 的組合有著 (scalar, vector) 或是 (vector, scalar) 的組合, 一共有 4 種類型. 從使用面向上來看這兩種有著不同的應用:

  • scalar base + vector offset/index - 使用單一的 base, 搭配個別的 offset/index, 也就是說這適合單一起點的 structure of arrays 的方式
  • vector base + scalar offset/index - 使用單一的 offset/index, 搭配個別的 base, 也就是說這實際上非常適合應用在讀取 array of structures.


Fig. 4 - Vector Address 計算的相關 intrinsic 說明

最後是輔助 Gather & Scatter 的 vector address 計算的功能, 在 ARM SVE 中提供了 ADR 以及 INDEX 這兩個指令, 前者提供了 per-lane 的個別計算, 後者是以 base 與 steps 兩個參數來規律地計算產生整個 vector (事實上這個 index function 也可以用在需要等差級數的 vector 時候, 像是 shuffle 這類的情況)

下一篇會進入 ARM SVE 研讀筆記的最後一篇 Part-6, 除了介紹最後一個功能特性 - extended floating-point horizontal reductions 之外也討論 SVE / SVE2 各自涵蓋的功能特性範圍.


2022年2月28日 星期一

ARM SVE 研讀筆記 Part-4 - Predicate-driven loop control and management 與 Vector partitioning & software-managed speculation

Predication-driven loop control and management

Fig. 1 - Part-3 中使用的 ARM 官方 SVE 範例

事實上在 Part-3 的 ARM 官方範例中, 就已經展示了這個特性, 在 ARM SVE 中提供了 WHILELT 與 WHILELE 指令來作為遞增 for loop 中的 > 與 >= 的比較, 並產生對應所需的 predication 結果來處理在一般 SIMD 當中較不方便處理的 loop 結尾, 這是由於 loop 的結尾所需處理的數量很可能並非是 vector-size 的倍數, 而記憶體存取的位置也很可能並非 vector-size aligned. 在範例中可以看到使用了 svwhilelt_b64, 這即為 SVE 提供的 loop control / management 功能. 在 ARM SVE  中針對處理資料寬度提供了各自對應的 intrinsic functions:

  • 8bit - svwhilelt_b8 / svwhilele_b8 / svcntb 
  • 16b -  svwhilelt_b16 / svwhilele_b16 / svcnth
  • 32b - svwhilelt_b32 / svwhilele_b32 / svcntw
  • 64b - svwhilelt_b64 / svwhilele_b64 / svcntd

而在 ARM SVE2 中針對遞減 for loop 增加了 WHILEGT 與 WHILEGE, 很直覺地這是用來處理 loop control 中的 < 與 <= 的比較.

  • 8bit - svwhilegt_b8 / svwhilege_b8 
  • 16b -  svwhilegt_b16 / svwhilege_b16
  • 32b - svwhilegt_b32 / svwhilege_b32
  • 64b - svwhilegt_b64 / svwhilege_b64

Vector partitioning & software-managed speculation

在許多時候 buffer 的長度並非 vector size 的倍數, 這造成 vector load 的行為可能會超過 buffer 邊界, 或是要處理的資料的長度未知, 可能在處理過程中造成 memory fault 的行為. 而在讀取過程中, 可能有因計算需求的其他對應的 vector load. 對於這樣的需求, ARM SVE 導入了 First-Faulting 與 Non-Faulting vector load 的設計.

Fig. 2 - ARM SVE 使用的 register set

在 ARM SVE 的 register set 中有著一個不起眼的 register - first-fault register (FFR), 其寬度與 predicate register 相同. FFR 的目的在於存放執行 first-faulting or non-faulting vector load 中每個 lane 成功與否的結果. 

Fig. 3 - first-fault register 運作機制

而 first-faulting 與 non-faulting 的差異在於 first-faulting vector load 的 VLDFF1 系列指令中, 只有第一個 active lane 會產生造成例外情形的 memory fault. 而 non-faulting vector load 的 VLDNF1 系列指令按照字義上而言就是不會產生 memory fault 的指令. 此外, 無論使用 first-faulting 或是 non-faulting vector load 的時候, 在 FFR 中每個 lane 對應的值若事先已被設為 0 / false, 那麼該 lane 的結果將會是 unknown 狀態. 

Fig. 4 - First-Faulting Vector Load 範例

在 Fig. 4 中為 ARM C Language Extension 對於 first-faulting 的範例. 一開始執行 SETFFR 之後, FFR 的所有值都會為 1/true, 接著連續執行三次 LDFF1 指令, 將指定資料讀取至 Z0 ~ Z3. 最後透過 RDFFR 指令將 FFR 的內容存放至 P3 當中. 而 P3 所存放的數值表示哪些 lanes 在 Z0 ~ Z3 當中皆為 valid 狀態. 此資訊對於一些不定數目但需要合併處理的情況相當有幫助.


3/21 - 感謝來自 FB 臉友 王北北 的指正, SVE 與 SVE2 支援的 WHILELT&WHILELE 與 WHILEGT&WHILEGE 一時不察寫反了, 已修正

2022年2月26日 星期六

ARM SVE 研讀筆記 Part-3 - Per-lane predication

在切入 ARM SVE 第二個特性 - Per-lane predication 之前, 讓我們先以 ARM 官方 SVE 範例程式為例, 說明 SVE 的  C/C++ 程式看起來會是怎樣的型態.

使用 SIMD Intrinsics 依然是性價比相當高的方式, 除了可以直接與 C/C++ 程式碼混合撰寫外, 也避免了直接使用 assembly 撰寫的曠日費時與難以除錯. 當然使用 SIMD intrinsics 的缺點是可攜性與跨平台問題. 這點就在先前文章多少提及, 在此就不綴述. 這裡讓我們以第一個範例來切入 SVE intrinsics 的使用

Fig. 1 - SVE  intrinsics 使用範例程式 double dot

Fig. 1 中的程式來自 ARM 官方 SVE intrinsics 的範例, 這當中有幾個重點:

  • 首先是第一行藍色標示的部份, "arm_sve.h" 的使用對 SVE intrinsics 是必要的
  • 在上一篇有談到 SVE vector type 型別的使用來宣告變數, 上圖中以草綠色標示
  • 如同一般的 ARM NEON 程式, 呼叫所需要的 intrinsic function, 這裡以暗紅色標示. 值得一提的是, 雖然相較於 NEON intrinsics,  SVE 增加了 postfix 來做特定用途. 但多數基本功能, 都可以將 ARM NEON intrinsics 原有的名稱在開頭加上一個 "s" 並且移除用來判別處理 64/128-bit 寬度的 "q", 就可以索引到所需的功能. 例如, 原本做 float 型別的vector element 總和會使用 vaddvq_f32, 這裡就可以去搜尋到 Fig. 2 中所列出的 svaddv_f32
  • 最後是紫色標示的部份, 這也是本文要說明的 Per-lane predication, 在 ARM SVE 中新增了在 DSP SIMD 中常見的 Per-lane predication, 這能用來做更為細緻的控制, 來減少在程式撰寫中因 SIMD 限制而不得不以 scalar code 來處理的部份. 這個範例精簡地展示了 predicate 用在 SVE 中的 3 個 predication 特性 - 本文的 per-lane predication 與後續的Predicate-driven loop control and management 與 Vector partitioning & software-managed speculation.
Fig. 2 - 透過 NEON vaddvq_f32 能找到的 SVE intrinsics 系列

所謂的 Per-lane predication 功能是指在 SIMD 中在套用的操作上, 對於每個 lane 提供一個 bit 來做 active or inactive 的控制. 而 active lane 即表示需要直接套用所使用的操作. 對於 inactive lane 部份則有幾個模式, 這點會在稍候解釋.

Fig. 3 - predication 圖示

在 ARM SVE 的設計上對於多數 intrinsic function 都加入了 svbool_t 型別的參數 pg, 這即是用來作為 lane control 的 predication. 其基本概念如 Fig. 3 所示, 一旦該 lane predication 值為 1/true 的即表示該 lane 狀態是 active; 而若該 lane 的 predication 值為 0/false 的, 該 lane 狀態即為 inactive. 若 intrinsic function 沒有特別的 postfix, 那麼 inactive lane 則是維持原本的數值.

Fig. 4 - Predication register 對應 Vector register 的方式.

若對 Part-1 的內容還有印象的話, ARM SVE 的 vector register 為 128b 的倍數, 可為 128~2048b 的任何選擇. 而 predication register 為 16b 的倍數, 可為 16~256b 的任何選擇. 但 predication register 與 vector register 長度的關係是連動的. 一旦決定了 ARM SVE 中關於 vector length 的 LEN 參數, 就固定了兩者的長度. 這也表示 vector / predication 是以 8:1 的比例對應的. 對於 8b 以上的型別會有額外的 bit. 這時的選擇方式如 Fig. 4 所圖解的, 對於 16/32/64b 的 data types, 是以對應的多個 bits 之中最低位的 bit 來控制該 lane.
Fig. 5 - Predication 產生與操作的方式

到此可以輕易地理解, Predication 通常是用來處理 SIMD 中通常難以處理的 if/else 或是 switch case 等等的流程. 因此 predication 的產生最直觀的就是對應 C++ boolean type 中的許多 logical operations - 舉凡數值間各種比較運算 !=, ==, <, <= , >, >= 與 boolean type 間各類 !, &&, || 等等.

Fig. 6 - Inactive Lane 的模式

最後是 inactive lane 的動作, 依照所使用的 intrinsic function 共有 3 種, 也就是在一些 intrinsic functions 的名稱中在 data type 之後還可以看到 "_z", "_m" 或是 "_z" 的 postfix. 這是對於 inactive lane 模式的選擇. 使用了 "_z" 結尾的 intrinsic function 表示了希望 inactive lane 的數值填為 0; 而使用了 "_m" 結尾的 function 則是代表維持原本輸入的第一個 vector 參數並不做任何的更動; 最後是 "_x", 這表示不在意 inactive lane 的數值, 讓 compiler 去針對 compilation 參數(performance or code size)去作較佳的選擇( _z, _m 或是甚至不使用 predication ), 一旦使用 "_x" 的 intrinsic function 必須清楚地知道, inactive lane 當中並沒有預設或保證當中為何值.

下一篇將延續 Per-lane predication 來同時講述 Predicate-driven loop control and management 與 Vector partitioning & software-managed speculation.


ARM SVE 研讀筆記 Part-2 - Vector Length Agnostic (VLA)

個人認為 Vector Length Agnostic (VLA)  是討論 SVE 時必須先討論的特性. 談到這特性必須先了解多數的 SIMD 指令集都有固定使用的 vector width/length, 像是 intel 對於 x86 平台的 SIMD 發展過程, 從 MMX 的 64-bit 開始, 一路發展 SSE / 128-bit , AVX & AVX2 / 256-bit 到最近的 AVX-512 / 512-bit 每一組都有固定的 vector length, 但是即便使用相同的運算, 對於使用了不同的 SIMD instruction set, 這也必須對應到 CPU 內不同的 opcode. 因此使用舊的 SIMD instruction 的程式並無法受益於新一代 SIMD ISA 的好處.

而 ARM SVE 在制定時一開始就允許 IC 商能夠依照應用的需求的考量, 去配置硬體內的 SIMD vector length. 另外制定 SVE 專屬的 VLA vector type 與 intrinsics, 讓開發者能夠達到撰寫所撰寫的 ARM SVE 程式無需特別針對 vector length 改寫或重新編譯, 即可執行運作. 而 IC vendor 也能更為安心地藉由增加 vector length 達到效能增加而無需擔心程式的重新客製問題.

Fig. 1 - Vector Length Agnostic 的圖解與程式特性

類似於其他各 SIMD 指令集的 C intrinsics, 需要對應的 vector type 與 intrinsics function. ARM 對於 SVE,  也提供了對應的 vector type 以及 function 介面. 如 Fig. 2 中所列出的, 其 vector type 涵蓋了基本的 8/16/32/64-bit signed / unsigned int 與 float / double 等等, 然而還增加了 boolean, float16 與 bfloat16 等等新的型別.
Fig. 2 - ARM SVE intrinsics提供的 vector types

然而這些 Vector types 與其他 SIMD intrinsics 所提供的最大不同是這些是 "sizeless", 也就是對於 compiler 而言,  這些 vector types 並沒有俱備任何 size 資訊. 於第一時間或許覺得沒大問題, 但是事實上 VLA 帶來了許多在語言特性以及工具使用上的限制: 

Fig. 3 - Sizeless 帶來的實務限制

如 Fig. 3 所列出的, VLA 帶來的限制主要都是因為缺乏 size 資訊造成需要此資訊的語言特性使用的限制. 這些包含了無法去使用 sizeof / alignment, pointer arithmetic. 比較不直覺的像是無法作為 union / struct / class 的 member field 與宣告用來存放的 STL container , 另外無法成為 exception handling 中 throw / catch 機制的 object. 最後是 lambda 中 capature 機制無法 capture by value. (但是能夠使用 capture by reference )


2022年2月25日 星期五

Halide 實務心得 5

在實作影像處理演算的過程或是實務的功能整合中, 都圍繞著 Halide::Runtime:: Buffer 的使用. 有時難以避免需要初始化預設值或是從其他 Buffer 物件複製資料. 這些可以透過 Buffer::fill() 或是 Buffer::copy_from 來做基本的填值處理.

對於一些相當 routine 但是卻又需要計算的部份,  通常會透過 loop 來走過每個座標, 甚至每個一個 value. 像是做簡單的 gamma correction 可能就會做這樣的動作:

Buffer<uint8_t, 2> src = Buffer<uint8_t>(w, h);
...
Buffer<uint8_t, 2> dst = Buffer<uint8_t>(w, h);
for(int y = 0; y < dst.height(); y++){
    for(int x = 0; x < dst.width(); x++){
        for(int c = 0; c < dst.channel(); c++){
            dst(x, y, c) = gamma(src(x, y, c));
        }
    }
}

或是可能是格式轉換 (像是 RGB <-> YUV 或是這裡的 Demosaic):

Buffer<uint8_t, 2> src = Buffer<uint8_t>(w, h);
...
Buffer<uint8_t, 2> dst = Buffer<uint8_t>(w, h);
for(int y = 0; y < dst.height(); y++){
    for(int x = 0; x < dst.width(); x++){
        uint8_t r, g, b;
        demosaic(src(x, y), r, g, b);
        dst(x, y, 0) = r;
        dst(x, y, 1) = g;
        dst(x, y, 2) = b;
    }
}

一旦數量很多, 或是 dimension 很大一一撰寫 loop 除了費時費力外, 也讓 code 不易維護與可讀性不佳. 對於這種問題, Halide 透過了 C++ lambda 的方式能夠簡短地處理, Halide Buffer 提供了兩個在其官方教學沒有提到的兩個實用的方式: for_each_value 與 for_each_element :

對於 Gamma 的例子可以簡短地改寫為:

Buffer<uint8_t, 2> dst = Buffer<uint8_t>(w, h);
dst.for_each_value([&](uint8_t &dval, uint8_t &sval){
    dval = gamma(sval);
}, src);

而對於像 demosaic 的例子則可以改寫為:

Buffer<uint8_t, 2> dst = Buffer<uint8_t>(w, h);
dst.for_each_element([&](int x, int y){
        uint8_t r, g, b;
        demosaic(src(x, y), r, g, b);
        dst(x, y, 0) = r;
        dst(x, y, 1) = g;
        dst(x, y, 2) = b;
});

 這樣的作法也適合套用在一些特殊的初始化.

2022年2月21日 星期一

How to make "Dark mode" listed in Facebook APP on Android Tablet

I've been annoyed by Facebook's dark mode on my Android tablet for a long time. 
After one of the update several months ago, my Facebook app doesn't list "dark mode" on menu any more. All articles on the internet said you can find it under "Setting & Privacy" of burger menu. But I just can't find it for a long time


Today I accidentally found the root cause. Therefore I write this to share my finding in English to let more people know about the tricky thing. It's all about display setting. If you have the same issue, please check your "Display size" in the "Display" menu of Settings. 

For some Android tablet users, they want to show more on the screen, so it would be changed to "default", "small", "smaller", or "smallest". There is no identical setting that will make dark mode be shown on menu. Just try "default", "large", "larger" or "largest" one bye one. After eche changing of the setting,  please remember to kill Facebook app and the relaunch it. Then you will find a setting that works. (According to my experience, the "middle" one will be the first working setting.)


Hope this article would be helpful for some people.

2022年2月16日 星期三

ARM SVE 研讀筆記 Part-1 - ARM SVE 基本概述

ARM 於 ARMv8.2 時期開發了新一代 SIMD 指令集, 以選擇性擴充的方式來接替已使用多年的 NEON, 並在 ARMv9 中預設涵蓋, 該 SIMD ISA 全名為 Scalable Vector Extension 簡寫為 SVE. 這中中最著名的使用案例是與富士合作的 ARM 超級電腦平台中使用了配置為 512b vector length 的 SVE 實作. 相較 NEON 而言, SVE 除了新增功能特性的設計上, 除了增進便利性, 也同時一併考慮了 SIMD 效能擴充 / 延伸性的問題. 

Fig.1 - ARM SVE vector register 與 NEON register 關係圖.

ARM SVE 的設計最特別的地方在於它採用了不同於現今主流 CPU / DSP 皆以 fixed vector length 來制定出一組 SIMD 指令集的方式. 在設計上採用了硬體實作中可對於內部 vector length 作可調整配置的方式, 這也是名稱上使用了 "Scalable" 一詞的原因. ARM SVE 允許硬體商因應用效能上需求的考量而去決定 vector length, 越長的 vector 因為需要更多的 ALU 來提供 ILP, 也會直接地反映在 die area 上. 而 ARM SVE 的 vector length 選擇上必須是介於 128~2048b 而且為 128b 的倍數.

Fig. 2 - ARM SVE 新增的 predicate register.
設計上與 ARM NEON 的另一個重大差異, 在於 ARM SVE 導入 16 個 predicate register.  這是用在於 DSP SIMD 中相當常見的 Per-lane predication 用途上. 在此必須特別說明的是於 Fig. 2 中的 LEN 參數與 Fig. 1 的是連動的相同數值, 這表示 IC vendor 選擇了 LEN 就同時固定了 vector 與 predicate register 的長度, 因此兩者長度的比例固定為 8:1. 在 ARM SVE 中透過使用  predicate, 能夠精確的控制個別資料的計算與否, 如此處理一些 if/else 等等的狀況會更為便利. 由於 SVE 的進階功能都圍繞著 predication 的使用, 因而 SVE 也有著對 predication 運算操作的指令.
Fig. 3 - 總結 ARM SVE 的重大特性

個人統整認為 SVE 的主要特性有 1(個人認為應該加入) + 5, 分別是:

  • Vector Length Agnostic (VLA)
  • Gather-load and Scatter-Store
  • Per-lane predication
  • Predicate-driven loop control and managment
  • Vector partitioning for software-managed speculation
  • Extended floating-point and bitwise horizontal reductions.

後續陸續將這些心得一一分享. 下一篇將介紹說明 Vector Length Agnostic (VLA)

2022年2月9日 星期三

Halide 實務心得 4

這陣子因為同事在弄 Hexagon DSP 且需要實作 Laplacian Pyramid 來完成所需功能, 由於這是 Halide 當初推出時 paper 內說明的範例, 所以搜尋了一下檔名, 建議他參考 Halide git repo 內的 Laplacian 範例.

今日與演算開發者開會討論時, 這位同事建議演算開發者考慮去使用 Halide language, 並且以當中的 downsample 為範例解說給演算開發的同事聽. 這時我注意到了 downsample 中有著先前沒看過, 另外也沒在任何 Halide 文件 / 教學文件提到的東西:

using Halide::_;

最有趣的是透過使用 "_" 所實作的 downsample Funciton:

Func downsample(Func f)
{
    using Halide::_;
    Func downx, downy;
    downx(x, y, _) = (
        f(2 * x - 1, y, _) +
        3.0f * (f(2 * x, y, _) + f(2 * x + 1, y, _)) +
        f(2 * x + 2, y, _)
    ) / 8.0f;
    downy(x, y, _) = (
        downx(x, 2 * y - 1, _) +
        3.0f * (downx(x, 2 * y, _) + downx(x, 2 * y + 1, _)) +
        downx(x, 2 * y + 2, _)
    ) / 8.0f;
    return downy;
}

很明顯地, "Halide::_" 是用來處理 function 內 argument / dimension 不定數量的問題. 然而詳細的使用應該有正式的解說, 經過搜尋後發現在 Halide 文件中的 Var 當中, 這個功能稱為 Implicit Variable Constructor. 文件中的解釋為: "Implicit variables are injected automatically into a function call if the number of arguments to the function are fewer than its dimensionality and a placeholder ("_") appears in its argument list. Defining a function to equal an expression containing implicit variables similarly appends those implicit variables, in the same order, to the left-hand-side of the definition where the placeholder ('_') appears." 這也就是說在 function 呼叫若使用了 "_" 在參數 list 中 , 一旦參數的數目少於函數所需參數, 將會自動對應遞補足. 透過使用 implicit variable "_" 來定義一個函數, 這表示函數有著以 "_" 出現所代表的參數 list. 

透過 implicit variable constructor 如此可以無論傳進的 Func f 有幾個參數, 像是對於影像處理的函數而言, 最前面兩個參數能固定被使用作為座標的 (x, y), 而對應的維度在處理時將直接補足對應. 因此無論純 2D 黑白影像可以套用外, 3D (有3個參數, 分別為 Width, Height, Channels) 的 RGB / RGBA / YUV444 等等影像都可以直接套用這個 downsample 來處理, 更重要的是參數更多的更高維度資料都可以因此而透過單一實作來處理. 另外應可以搭配 RDom / RVar 來使用, 像是上述程式碼中的 downx / downy 的範圍, 搭配 RDom 來使用, 應該能實作出更為簡潔的 Func 表示方式.


2021年9月15日 星期三

Halide 實務心得 3

在 Halide 的使用上會有錯覺地認為 Halide::Runtime::Buffer 的使用必須與 libHalide.so or libHalide.a linking 才可以. 但其實 Halide::Runtime::Buffer 是可以單獨使用的, 只需要 header files, 基本上一般的程式只要確認有:

#include <HalideBuffer.h>

並且確認編譯時有在 include path 即可, 單獨的使用上並不需要任何 libHalide, 相較使用 raw pointer 或是 STL 元件, 這樣的方式有很多的好處:

  1. 俱備 reference count 特性
  2. 提供類似函數的存取介面
  3. 能夠彈性的配置 planar 或 interleaved 資料
  4. 能夠帶入或取得 raw pointer
  5. 可搭配 halide_image_io.h 來載入/另存 jpeg or png 圖檔

俱備 reference count 特性

現今的 C++ 元件多半具有這樣的特性, 除了使用上的簡潔彈性外, 好處是可以減少程式中充斥自行管理 buffer/object 管理上的配置與釋放相關的程式碼, 除了有效避免 memory leak / double free 之外, 也能降低因 pointer 操作的錯誤發生. 而這樣的特性也讓程式中對於 Buffer 的指定與傳遞更為便利.

提供類似函數的存取介面

Halide::Runtime::Buffer 並不是單純地提供 Halide 所使用的 Buffer object 存在, 每個所配置產生的 Buffer object 是能夠做存取操作的, 與 STL 不同的地方是, Halide::Runtime::Buffer 使用的是類似函式呼叫的形式來存取資料, 假設我們如下宣告了一個 Buffer.

Buffer<uint8_t> rgb_planes(1920, 1080, 3);

概念上,  這配置了 Width - 1920, Height - 1080, Channel - 3 的 Buffer, 也就是 sizeof(uint8_t) x 1920x1080x3 大小的記憶體空間, 每個 channel 有 1920x1080 , 而要存取該特定的位置, 可以使用下列方式:

// write to a pixel of a channel

rgb_plane(100, 100, 0) = 128

// read a pixel of a channel

uint_8 pix_val = rgb_plane(200, 200, 1)

可以減少計算 buffer offset 的錯誤, 程式碼也更為簡潔, 而因為採用了類似函數的形式, 程式的邏輯過程會更接近 functional 的感覺. 另外是也方便將查表轉為計算實作的驗證流程.

能夠彈性的配置 planar 或 interleaved 資料

許多的圖形資料並非單存以基本的 planar 形式存在, 難免會需要操作 interleaved RGB or RGBA 的資料, 以 Halide 參數順序代表資料格式與 loop 巢狀結構的概念, 那麼要宣告先前 rgb_plane 的 interleaved 版本, 必須這麼宣告:

Buffer<uint8_t> rgb_planes(3, 1920, 1080);

這的確是可行的, 但操作 planar 與 interleave 的程式流程就會使用不同的 index 次序, 而為了解決這樣的方式 Halide::Runtime::Buffer 提供了 make_interleaved 的介面來建構這樣的 Buffer object. 而最大的優點為, 這能夠保有與上一點相同次序的存取方式, 而對應底層不同的 memory layout.

能夠帶入或取得 raw pointer

為了銜接一些其他的實作或操作, 像是使用 OpenCV library 或是以 SIMD 加速的程式, 在 Buffer 的宣告上是能夠傳入外部的 pointer. 相對地需要 Buffer 對應的 buffer pointer 是能夠透過 Halide::Runtime::Buffer::data() 這個呼叫取得. 如此就能銜接/整合/驗證以不同方式實作的資料處理功能.

可搭配 halide_image_io.h 來載入/另存 jpeg or png 圖檔

在 Halide tutorial 中使用的 load_image 與 save_image 對於實務上是很便利的工具,  這也能在 include halide_image_io.h 之後個別來使用, 而需要注意的是這會需要 link libpng 與 libjpeg.


在 ARM 平台上使用 Function Multi-Versioning (FMV) - 以使用 Android NDK 為例

Function Multi-Versioning (FMV) 過往的 CPU 發展歷程中, x86 平台由於因應各種應用需求的提出, 而陸陸續續加入了不同的指令集, 此外也可能因為針對市場做等級區隔, 支援的數量與種類也不等. 在 Linux 平台上這些 CPU 資訊可以透過...