2018年7月31日 星期二

永別了, Computer Vision

在 LinkedIn 頁面上看到了這篇有意思的文章, 以透過將 Computer Vision 領域擬人化, 原以為終於發現一個能長久對話的朋友, 然而現在卻因為虛弱以至於死去, 必須對此撰寫一封對它的告別信. 而更有意思的是作者是服務於 Apple 於影像視訊資料處理專業的工程師. 而告別的原因不為了別的,正是因為 ML/NN 的熱絡與強大, 特別喜歡裡面的兩個句子:
  • Data will become your king, but your king has no intention of keeping you around longer than needed. (資料將成為你的王, 但你的王無意讓你再被需要)
  • After years of traditional methods, Face ID became a reality mostly because of data feeding the machine not because of some super crafty algorithm. (在傳統方法的多年之後, FaceID之所以能成為現實, 主要在於餵給機器資料而非充滿多端詭計的演算法)
作者不認為 CV 這十年會消逝, 也認為將會有其他演算的出現, 但是現實也往往傷人, FaceID 能商品化還是在於 ML/NN. 若稍有注意的話, 今年的 CVPR 2018 中有著大量使用 ML/NN 的方法與論文, 對於 CV 演算理論上或許必須要樂觀才能走下去, 然而 CV/Image Processing 是否正走在 Audio/Speech 被 ML/NN 橫掃的歷史道路上? 每個相關工作者在這樣的階段, 或許都有著不等的矛盾與挫折.

2018年7月26日 星期四

Vulkan Learning Resource


這篇主要在於集中整理先前在 Facebook 分享的各類 Vulkan 資源

Tutorial 類

Vulkan Tutorial
相當高品質的 Vulkan 教學網站, 甚至提供了電子書版本
https://vulkan-tutorial.com/

LunarG Tutorial
這是 LunarG 提供的 Vulkan SDK 文件的一部份
https://vulkan.lunarg.com/doc/sdk/latest/linux/tutorial/html/index.html
另外 LunarG 提供了相當有用的 Spec 參照
https://vulkan.lunarg.com/doc/view/latest/linux/vkspec.html

Intel  - API without Secrets: Introduction to Vulkan series
這系列文為 March, 2016 開始連載, 至今都還在更新, Part 7 為 April, 2018 發表, 日後會持續在此更新文章聯結
Part 0: Preface
Part 1: The Beginning
Part 2: Swap Chain
Part 3: First Triangle
Part 4: Vertex Attribute
Part 5: Staging Resource
Part 6: Descriptor Set
Part 7: Uniform Buffers — Using Buffers in Shaders

ARM
Vulkan API Tutorials

Misc
http://ogldev.org/www/tutorial50/tutorial50.html
https://gist.github.com/graphitemaster/e162a24e57379af840d4


主題文章

在各大 GPU vendor 有著許多說明 Vulkan 特定設計或設運作機制的說明文章, 不一定是 programming 教學, 文章都有所要深入探討的主題.

GPUOpen/AMD
以下項目主要是 GPUOpen 頁面上 Vulkan 標籤選取的

Nvidia
以下項目主要透過 Nvidia Developer 頁面的 Vulkan 標籤取得
ARM
Imagination
Intel
Khronos

2018年7月23日 星期一

在 Vulkan 中使用 OpenCL Kernel


OpenCL kernel 在 Vulkan 上的使用

OpenCL 自 2008 年底釋出 1.0 至今過了十個年頭,
在 GPGPU 面向上也累積了相當的開發者社群,
儘管 Desktop 上熱烈程度不如 Nvidia CUDA,
而 Mobile 上因 Google 的錯誤決定去強推 RenderScript,
造成手機商在配置與否的態度不一
這樣的情況造成 OpenCL 的使用程度上既不熱烈,
然而許多情況下又是唯一方案


在 Vulkan 的推出後,
由於其基於 SPIR-V 標準的特性, 讓許多應用能夠依附於此之上
其中之一即為 OpenCL kernel 的使用
透過預先以 compiler 將 OpenCL kernel 轉為 SPIR-V binary
再搭配 Vulkan 載入與使用 Compute Shader 的方式, 得以間接的使用 OpenCL 語法

所需的第一個工具為:
https://github.com/google/clspv
clspv 為將 OpenCL kernel 編譯出 SPIR-V 的 Compiler

再來即為 Vulkan 對應 OpenCL Host Code 的使用流程
網路上可以找到下列三篇提及 OpenCL Host => Vulkan 流程轉換的 Blog 文
OpenCL -> Vulkan: A Porting Guide Part I
OpenCL -> Vulkan: A Porting Guide Part II
OpenCL -> Vulkan: A Porting Guide Part III
以及該系列文作者於 Khronos Munich 2017 的簡報: OpenCL to Vulkan: A Porting Guide

若跳過對 OpenCL 與 Vulkan 的對應, 想直接切入 Vulkan Compute Shader 流程
該作者的 A simple Vulkan Compute example 一文以及 GitHub gist 幫助就相當大

個人透過上述幾篇, 實作了上述 Compute Example 等義的 CL kernel
並整合開源放上 https://github.com/champyen/vkcl
以 Intel HD Graphics 500 搭配 Mesa Vulkan 實作, 能正確執行

儘管因此能夠撰寫 OpenCL kernel 來在 Vulkan 環境中使用, 然而並不代表沒有任何限制
相關限制都在 clspv 的 OpenCLCOnVulkan 文件中

Kernel
  • argument 非 buffer/image 型別, 會透過整合到一個 buffer 方式傳入 
  • WorkGroupSize 無法透過 host 指定, 似乎只能以 __attribute__ ((reqd_work_group_size(x, y, z))) 方式指定
  • 無法呼叫其他 Kernel
  • 不能使用 local 作為 argument
  • 不能使用 half 作為 argument
(事實上, 相關 argument 自 Host 傳遞到 Kernel 的機制也並不是很方便)

Types
  • boolean 無法作為 global, constant, 而 sizeof 為未定義行為
  • 8-bit, 64-bit, event_t 型別無法使用
  • 沒有長度為 8, 16 的向量 (也就是儘支援向量長度 2, 3, 4)
  • pointer 的限制很多
Built-In Functions
這部分相當的多, 都是無法使用, 簡短提示如下:
  • atomic: atomic_xchg()
  • common: step(), smooth_step()
  • conversion: 俱備 rounding, saturation 都不可使用
  • math, integer, rational: 這部分特定的 function 無法使用, 請參考說明
  • async, shuffle, printf, vload/vstore: 請直接當不存在 ...

Vulkan GLSL Compute Shader

OpenCL kernel 在 Vulkan 1.0 上運作需要兩個 extension:

  • SPV_KHR_variable_pointers
  • SPV_KHR_storage_buffer_storage_class
此兩個 extension 於 Vulkan 1.1 中成為核心特性 (因此日後可以基於上述限制來使用 OpenCL)
若考量 Vulkan 1.0 裝置的相容性, 那麼採用 GLSL Compute Shader 方式撰寫是不錯的選擇

此外 Vulkan GLSL compute shader 的相關範例也並不多, 以下是看到覺得不錯的
https://github.com/Erkaman/vulkan_minimal_compute
https://github.com/alexhultman/libvc
https://arm-software.github.io/vulkan-sdk/basic_compute.html

撰寫 Vulkan GLSL compute shader 也需要 compiler 產生 SPIR-V
這時 LunarG 的 Vulkan Toolchain 能夠直接下載使用
https://vulkan.lunarg.com/sdk/home

update: 值得一提的是與 OpenGL GLSL compute shader 的不同, OpenGL GLSL compute shader 制定時, 能使用的 builtins 受限於既有 GLSL 部分, Vulkan 制定的時候對其做了擴充, 能使用的函式較接近原有的 OpenCL:
https://www.khronos.org/registry/spir-v/specs/unified1/GLSL.std.450.mobile.html

Facebook 開源其處理系統面 OOM(Out-Of-Memory) 問題的專案 - OOMD

儘管 Facebook 以 OOM Killer 來說明 OOMD, 但以 OOMD 在功能性上的描述以及 GitHub 專案上充斥著 detector 字眼, OOMD 應為 Out-Of-Memory Detector 的縮寫.
Facebook 旗下有著各式各樣的服務產品: News Feed, Messenger, Instagram, WhatsApp, Oculus 等等. 這些服務產品系統是基於散佈各地並以百萬計的伺服器來稱起. 當隨著基礎建設的與時地擴增, Facebook發現其主機與網路硬體涵蓋了數個世代. 橫跨多代環境的一個副作用是新版軟體或先配置更改可能導致系統在一台主機運行正常但在另一台主機上有著記憶體不足的問題.
Facebook 發現 Linux Kernel 中的 OOM Killer 有著處理時機過晚的情形,因此常會讓系統落入一種競逐資源而不斷地變換狀態的 Livelock 狀態. 為此目的 Facebook 才開發了 OOMD, 以不同的方式來解決記憶體不足的問題. (champ: 而與 Linux OOM Killer 最大的不同點有二: 一者為在於這是個 userspace 方案, 再者為 OOMD 是以預防的思維來面對 OOM 問題 ) OOM 其設計提供了兩個關鍵的功能特性:
  • pre-OOM Hook: pre-OOM Hook 主要目的在於軟體系統受到 OOM 威脅之前, 先提供對於對 OOM 問題的預警.
  • plugin system: 提供管理者能夠客製化在主機上對於每個工作負載的處理方式. 這主要在於提供了記憶體不足的問題更佳彈性的處理方式.
Linux OOM Killer 的主要職責在於保護 kernel, 使主機能正常運行; 在終止特定 process 來達成此目的時, 其並不會注意到該 process 背後可能的重要性. 因此當 OOM Killer 運作時存在著在主機上運行的應用程式都將乘受著重大風險. (champ: 對於 Facebook 這類公司而言, 風險就代表著損失的可能, OOM Killer 並沒有提供任何選擇, 相較直接終止帶來的服務終止, 使用者抱怨, 管理者發現與回復有著龐大的延遲. 在商業上應用會希望提供損失程度不同的方案選擇, 像是主機主動增加延遲, 積極地減少服務量, 背景持續將低重要性資料寫到 HDD/SSD/NVMs, 轉換為較少損失的方式來維持系統的可操做與控制性)
OOMD 的客製方案基於了兩個關鍵性的發展:
  • Pressure Stall Information (PSI): 這是一個由 Facebook 所開發正準備合入 linux upsteam 的系統工具. PSI 追蹤著三個系統主要資源: CPU, Memory 與 I/O, 觀察這些資源隨著時間的使用變化. 藉由回報因資源短缺造成的時間損失, 以此來提供整體工作負載可量化的測量.
  • Cgroup2: cgroup 為 linux 上用來做資源管理的系統. cgroup2 為新一代的設計. 而 OOMD 利用其複雜的精算機制來確認每個工作是否正常地運作.
由上述可以得知, 並非在一個系統上執行 OOMD 後就解決了問題. OOMD 是個對於系統資源提供的資訊系統, 以及預警發佈的機制. 必須有效解讀與利用 OOMD 提供的資訊, 並針對 OOM 發生前預先處理的方式有著事先的設計與規劃. OOMD 才算是正確的導入, 並且才能發揮最大的功效.
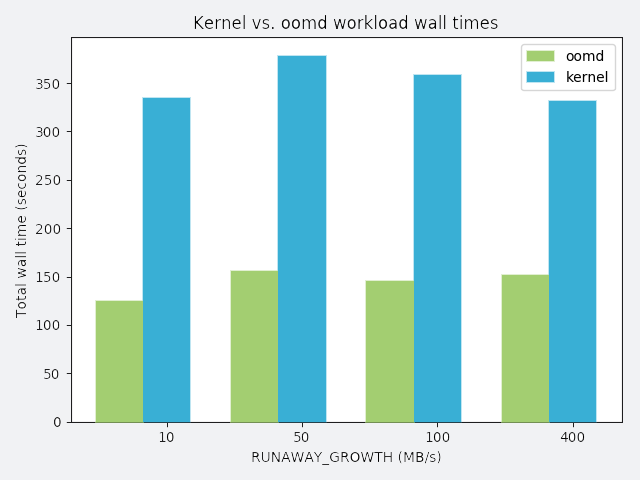
Facebook 稱實際運作上, 以此完全消弭了長達 30 分鐘的 livelock. 此外有著相關的實驗數據, 像是:
在程度不等的記憶體流失速度(a process that slowly leaks memory)下, 工作負載. 實驗所用的工作負載所需時間為 120秒,高於 120 秒時間都可以視為效能的降低. 由上圖可以比較使用 OOMD 不使用的情況下完成工作的時間. OOMD 僅有著小部分的效能耗損. 此外還有另外的兩個實驗, 詳情就留給大家自己研究.

2018年7月19日 星期四

Go Concurrency 基礎短篇

來源: https://medium.com/@matryer/very-basic-concurrency-for-beginners-in-go-663e63c6ba07
很不錯的 Go 平行處理的基礎文章, 文中所說明的 goroutines + wait group 方式應該適用超過八成的應用需求, 透過簡單的方式與範例說明 goroutine 的用法與為何需要 wait group. 以及以實際範例相較於非平行的差異. 文中的一句話很不錯:
I really love that adding concurrency in Go takes only three key presses, g, o and a space.
簡單, 貼切. 好語言不學嗎?以及

Symbol namespaces for Linux Kernel

近日 Martijn Coenen 提供了一份 patch, 主要在於提供 Linux Kernel 各 subsystem 的 symbol namespace 的功能.目前不確定是否與何時會合入 mainstream, 但是該 patch 為 Greg Kroah-Hartman (與很多developer) 所盼望的,或許不久的未來會正式支援.
在 Linux 4.17 中, exported symbol 總數已超過了 30000 個, kernel 開發者漸有了共識, 也就是 export 的範圍太大, 並且難以理解.
基本上這些 symbol 分為三類:
  • 對 drivers 有實際意義的 symbols
  • 由於功能性緣故被切分到多個模組的 symbols, 基本上不該被用在該 subsystem 以外.
  • 只對(目錄結構)樹狀內有意義的 symbols
這份 patch 的作用不在於減少 exported symbol 的數目, 而在於提供一個機制能夠提供一般性 export symbol 的秩序. 這份 patch 使得 subsystem 能夠將各自 exported symbols 放入個別的 namespace, 而模組開發者僅在需要的時候才 import 這些 namespaces.
這也使得 subsystem 維護者能夠輕易限制這些使用 namespace 的 symbol 對於 kernel 其他部份的使用. 也能夠分割出作為文件用途的 exported symbols; 像是, 一個僅作為 debugging 作用的 sysmbol set 可以放入名為“SUBSYSTEM_DEBUG” 的 namespace.
該成果受到 Greg Kroah-Hartman (LDD一書作者, linux stable kernel 維護者)的讚賞. 並稱讚使用 build system 為各別 subsystem 基於 symbol namespace 改變而自動產生 patch 令人驚豔.

邁向 ARM 64bit-only 的世界

展訊通訊(Spreadtrum Communications, 如果我開頭沒解讀錯誤)於 Linaro SFO 2017 簡報 ARM Binary Translator — Towards a 64bit Only World
 現在於 Android 裝置上通常會附上兩個版本的執行環境 — armeabi-v7a 與 armv8-a 來支援各種 Application 的相容 (主要還是 NDK 產生的 libraries & executables)
通常相關重複的函式庫資源會耗去不少儲存空間與系統的資源(最直接的就是 memory)
而這個 talk 基於今年曼徹斯特大學提出 MAMBO-X64 ARM Translator, 談論建立只有 aarch64-only 的系統環境, 而對於 32-bit 的程式需求則透過 translator 的方式來滿足
該 talk 涵蓋了自 kernel, system, code translation/generation 等等的面向: Addressing Space, Code Translation, Dispatching/Linking, Floating Point, Registers, System Calls, Memory Managment 等等
updated: 感謝好友 Trent Lo 提供不錯的觀點, 對於客製CPU 的 chip vendor , 這更能節省硬體的成本, CPU無須放入 32位元 相容實作的部分, 縮小 core size
延伸閱讀: Low Overhead Dynamic Binary Translation on ARM
https://www.research.manchester.ac.uk/portal/files/56078084/pldi_16.pdf

在 ARM 平台上使用 Function Multi-Versioning (FMV) - 以使用 Android NDK 為例

Function Multi-Versioning (FMV) 過往的 CPU 發展歷程中, x86 平台由於因應各種應用需求的提出, 而陸陸續續加入了不同的指令集, 此外也可能因為針對市場做等級區隔, 支援的數量與種類也不等. 在 Linux 平台上這些 CPU 資訊可以透過...